Como funciona o Higgsfield Genjutsu? E como o Maboroshi faz o mesmo trabalho por menos (2026)
By DeHub Team — 2026-10-24
O Higgsfield Genjutsu pega um vídeo real e troca uma única coisa nele: uma pessoa, um pet, um produto, uma roupa. O movimento de câmera, o ritmo e o fundo ficam exatamente como foram filmados. O Higgsfield não diz como funciona, então a maioria das pessoas acha que é um único modelo secreto.
Não é. Quando você desmonta, a edição no estilo Genjutsu é uma cadeia de oito etapas, e quase todo elo é um modelo aberto conhecido. Reconstruímos essa cadeia como Maboroshi, dentro do DeHub Creator. Rodar tudo por conta própria nos mostrou para onde o custo realmente vai, e é por isso que conseguimos cobrar menos.
Este guia passa por cada etapa com um quadro real de cada uma. Depois mostra como mudar uma cena inteira, quanto custa cada opção e o que acontece com o seu clipe depois de pronto.
O que o Higgsfield Genjutsu faz
Segundo a própria página do Genjutsu no Higgsfield, existem dois modos:
- Motion Transfer. O movimento do seu clipe conduz um novo personagem ou uma cena reconstruída.
- Object Swap. Um elemento que você indica é substituído e o resto da cena fica no lugar. Os exemplos do Higgsfield são produtos, objetos de cena e roupas.
Você envia um clipe de 4 a 30 segundos, adiciona até 30 imagens de referência e escolhe uma de mais de 30 predefinições ou escreve uma descrição curta. A saída vai até 1080p. O Higgsfield não diz quais modelos rodam por baixo.
O que dá para ver é o resultado. O movimento de câmera se mantém, a luz combina, o novo sujeito fica atrás dos objetos certos e a boca se mexe no ritmo da voz. Um modelo de texto para vídeo sozinho não consegue isso, então algo precisa medir o clipe original primeiro. Essa medição é o que chamam de engenharia reversa, e ela se divide em oito tarefas.
Como funciona, passo a passo
Nosso ponto de partida foi o Genjutsu Open Source Workflow de Sirio Berati, com licença MIT. Ele mostrou que o efeito podia ser reconstruído com peças abertas. Mantivemos as etapas que importam, trocamos as que não eram seguras para usuários reais e adicionamos pagamentos, revisão e recuperação. Cada imagem abaixo foi feita rodando a etapa em um clipe real.
Etapa 1: normalizar o clipe
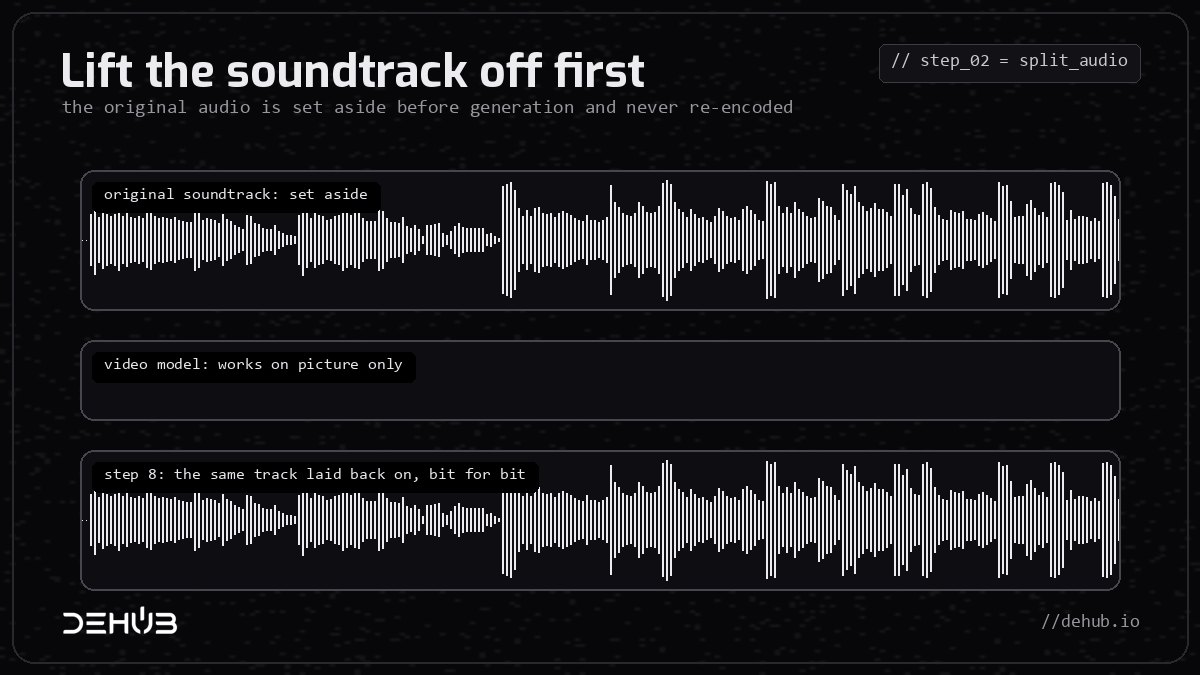
Cada envio é convertido para 24 quadros por segundo constantes e redimensionado para no máximo 960 pixels no lado maior. Vídeo de celular costuma ter taxa de quadros variável, o que faz o modelo sair de sincronia. Taxa e tamanho fixos dão a cada etapa seguinte a mesma grade de trabalho e mantêm o processamento rápido e barato.
O clipe deve ter 30 segundos ou menos e precisa ter uma faixa de som. Na rota Kling do Maboroshi ele deve ter de 3 a 15 segundos, com pelo menos 720 pixels em cada lado.
Etapa 2: tirar a trilha sonora
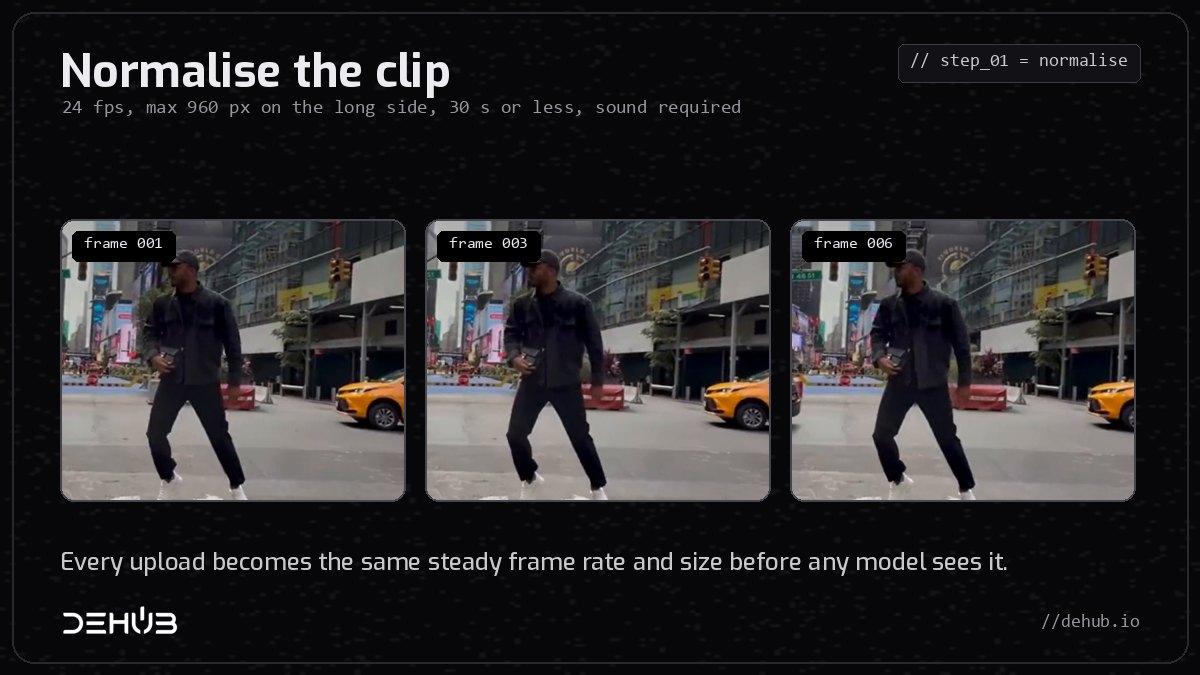
O áudio sai antes de qualquer geração. O Demucs, um modelo aberto, separa a voz da música, então o modelo de vídeo recebe só o que precisa. A faixa original completa fica guardada, intacta.
É por isso que o clipe final soa exatamente como o original. Modelos de vídeo são ruins com áudio: eles dessincronizam, borram ou inventam sons novos. Então a faixa original nunca passa pelo modelo.
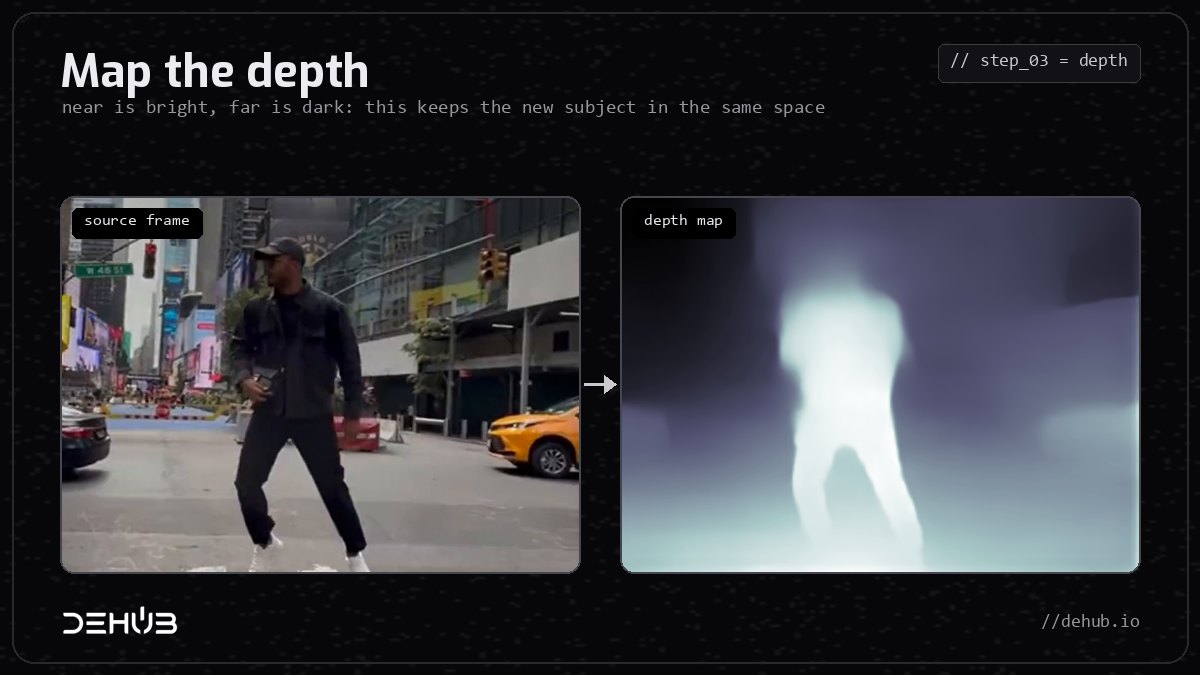
Etapa 3: mapear a profundidade
Um modelo de profundidade estima a distância de cada pixel até a câmera, quadro a quadro. O Maboroshi usa o Video Depth Anything, feito para vídeo e estável de um quadro para o outro. A imagem abaixo foi feita com um modelo de profundidade menor, de quadro único, mas a ideia é a mesma: perto é claro, longe é escuro.
A profundidade é o que faz o novo sujeito ficar no mesmo lugar, no tamanho certo, na frente dos táxis e atrás do poste. Sem ela, os personagens trocados parecem flutuar.
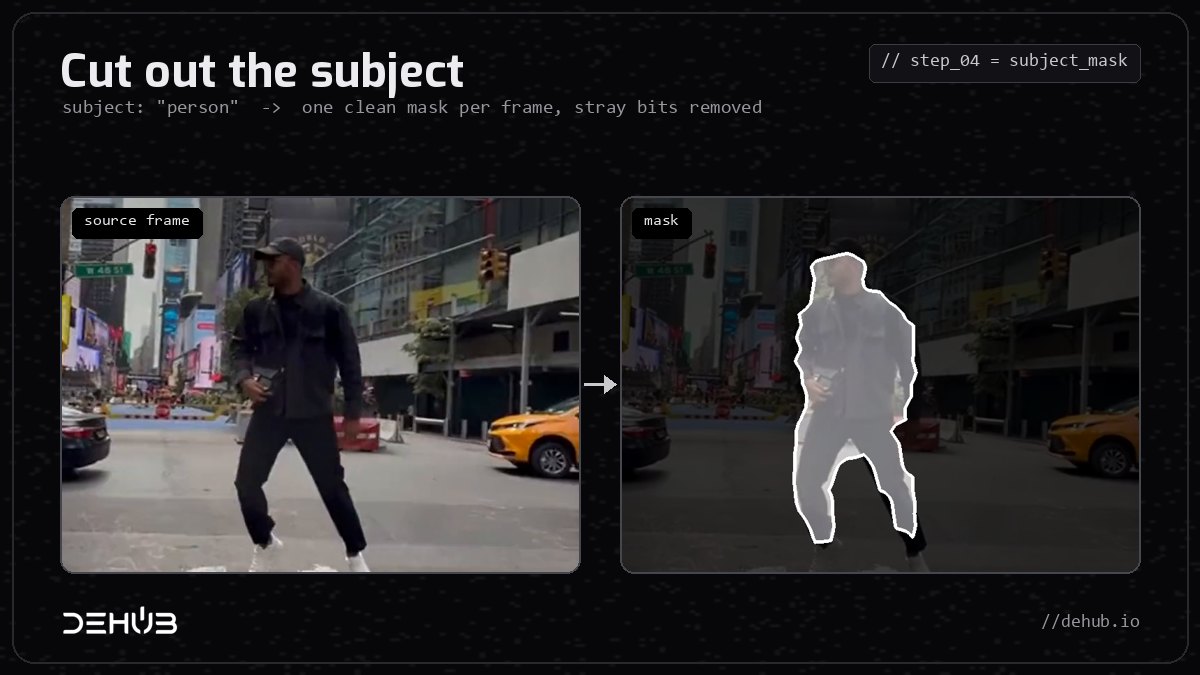
Etapa 4: recortar o sujeito
O SAM 3 Video, o Segment Anything da Meta para vídeo, encontra o sujeito que você indica (por exemplo "person") e desenha uma máscara limpa em volta dele em cada quadro. Pequenos fragmentos nas bordas são limpos automaticamente para que pixels soltos não confundam o modelo. A máscara diz ao renderizador exatamente o que substituir e o que deixar como está.
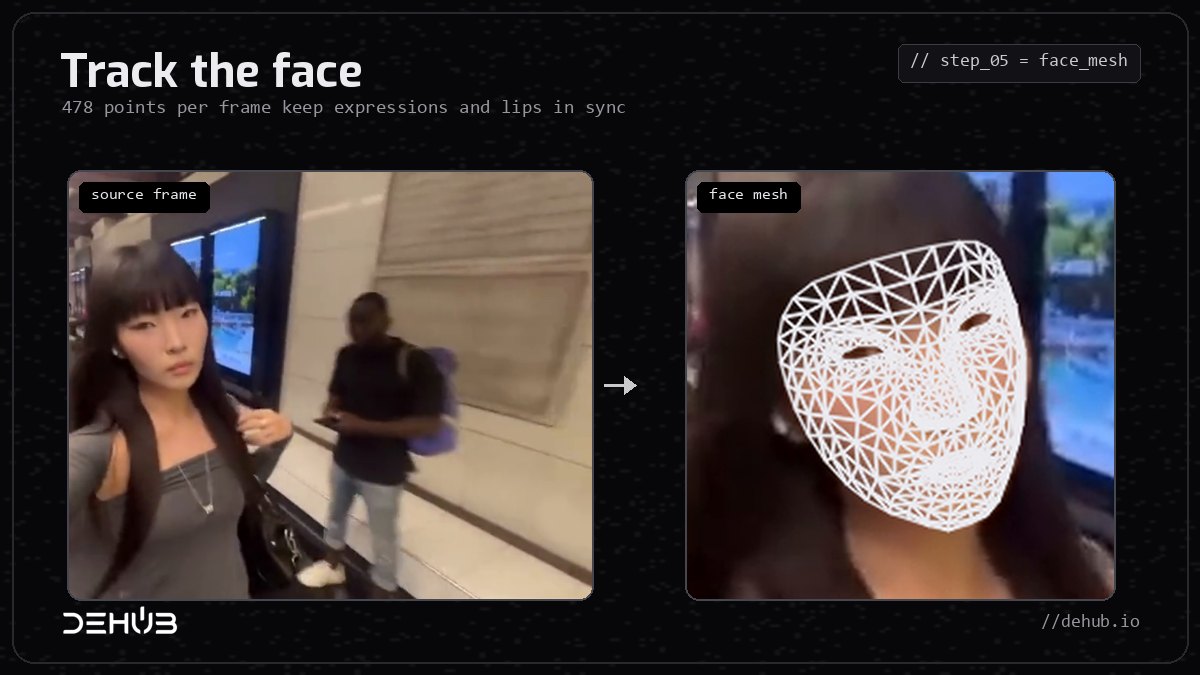
Etapa 5: rastrear o rosto
O MediaPipe Face Landmarker traça uma malha de 478 pontos sobre cada rosto, em cada quadro. Essa malha leva expressões, giros de cabeça e movimento dos lábios para o novo personagem. É por isso que um gato trocado ainda parece estar cantando a frase.
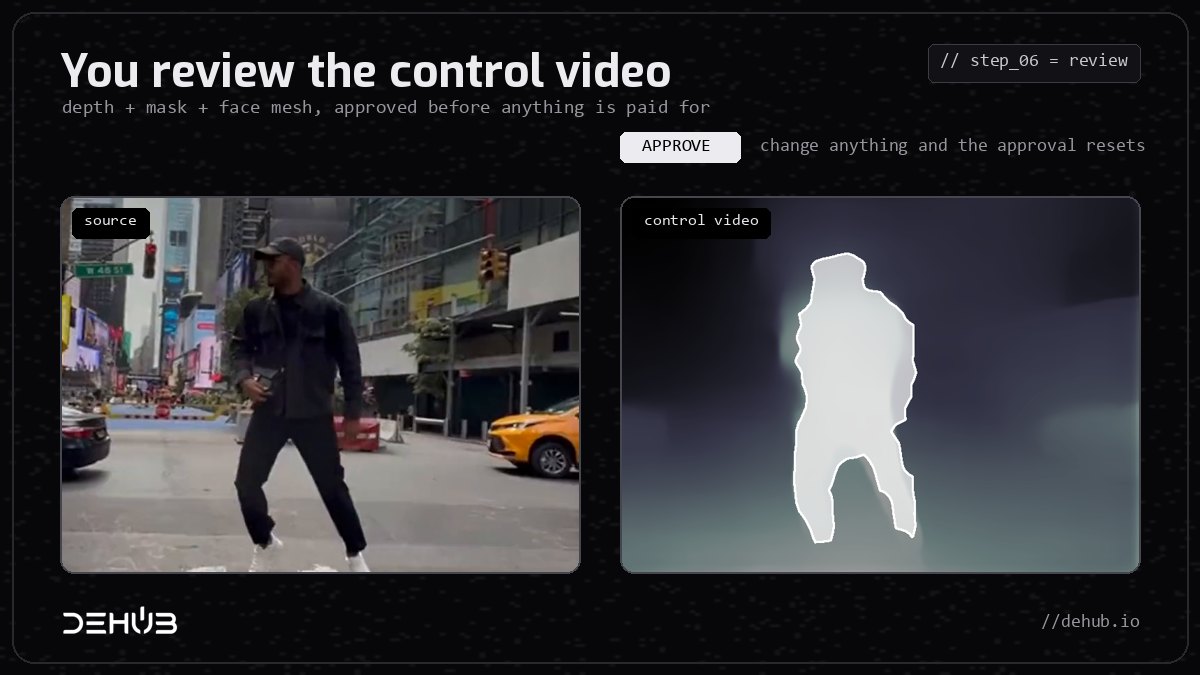
Etapa 6: você revisa o vídeo de controle
Profundidade, máscara e malha facial são combinadas em um único vídeo de controle, e você o vê antes que qualquer coisa cara aconteça. Se o recorte estiver errado, você para ali e não paga mais nada. A renderização final só roda na versão exata que você aprovou. Mudou o clipe, o sujeito ou a referência, a aprovação é zerada.
O Higgsfield não mostra essa etapa. Achamos que é a mais útil, porque uma máscara ruim é o principal motivo de uma renderização paga voltar errada.
Etapa 7: renderizar
A renderização acontece de uma de duas formas:
- Rota Seedance Premium. O Seedance 2.5 reference-to-video renderiza um rascunho barato a partir do vídeo de controle e das suas imagens de referência. Você só paga pelo 1080p se gostar do rascunho, e o final é concluído a partir desse mesmo rascunho, então você recebe o que aprovou.
- Rota Kling. O clipe original e uma ou duas imagens do personagem vão para o Kling O3 video-to-video edit de uma vez só. Sem preparação e sem rascunho. É mais rápida e mais barata, e é o nosso padrão para a maioria das trocas.
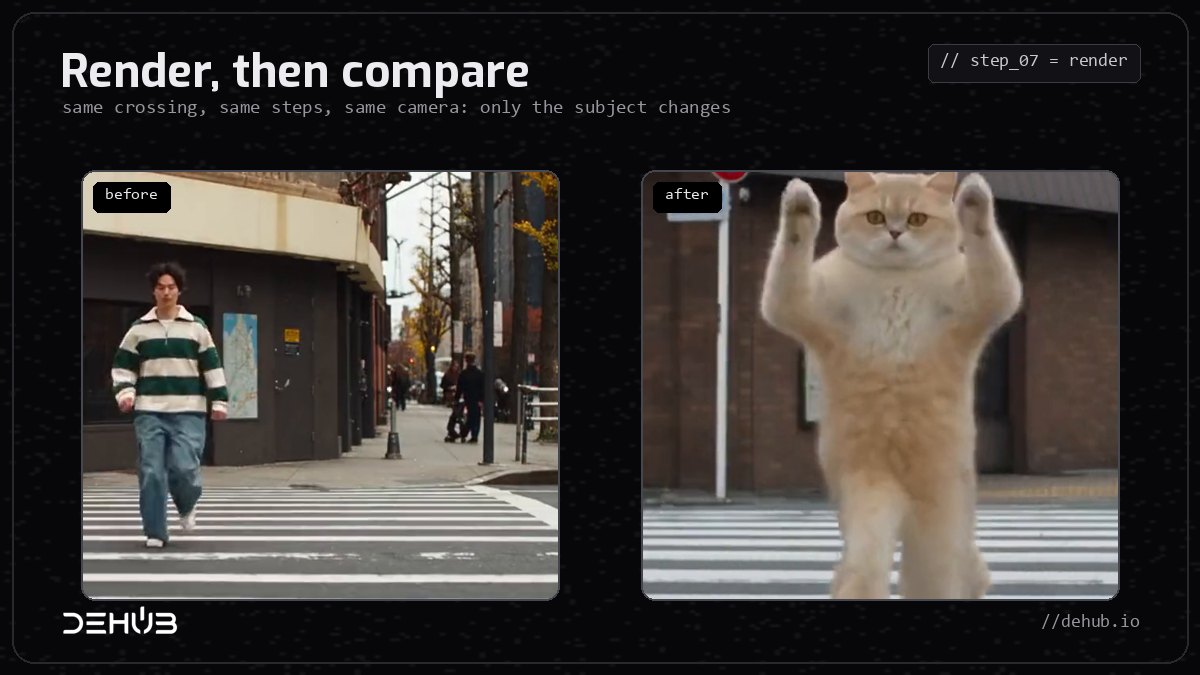
Etapa 8: devolver o som original
As duas rotas terminam recolocando a faixa de áudio original completa, copiada em vez de recodificada. A voz, a batida e o tempo ficam exatamente como você filmou, e é a primeira coisa que as pessoas notam ao comparar resultados lado a lado.
Mudar qualquer cena, ou qualquer coisa nela
Em 12 de outubro de 2026, o Higgsfield lançou o Katana, uma habilidade de edição que roda dentro de um chat de IA. Você entrega um vídeo de referência, ou uma predefinição da biblioteca dele, mais até cinco fotos de pessoas, produtos ou roupas. Ele reconstrói toda a edição em volta delas, mantendo a estrutura de cenas e o ritmo da referência, e só renderiza de novo as cenas que você corrige. Ele exige um plano ativo do Higgsfield e gasta os créditos desse plano.
A DeHub cobre o mesmo trabalho com três ferramentas, todas cobradas por clipe:
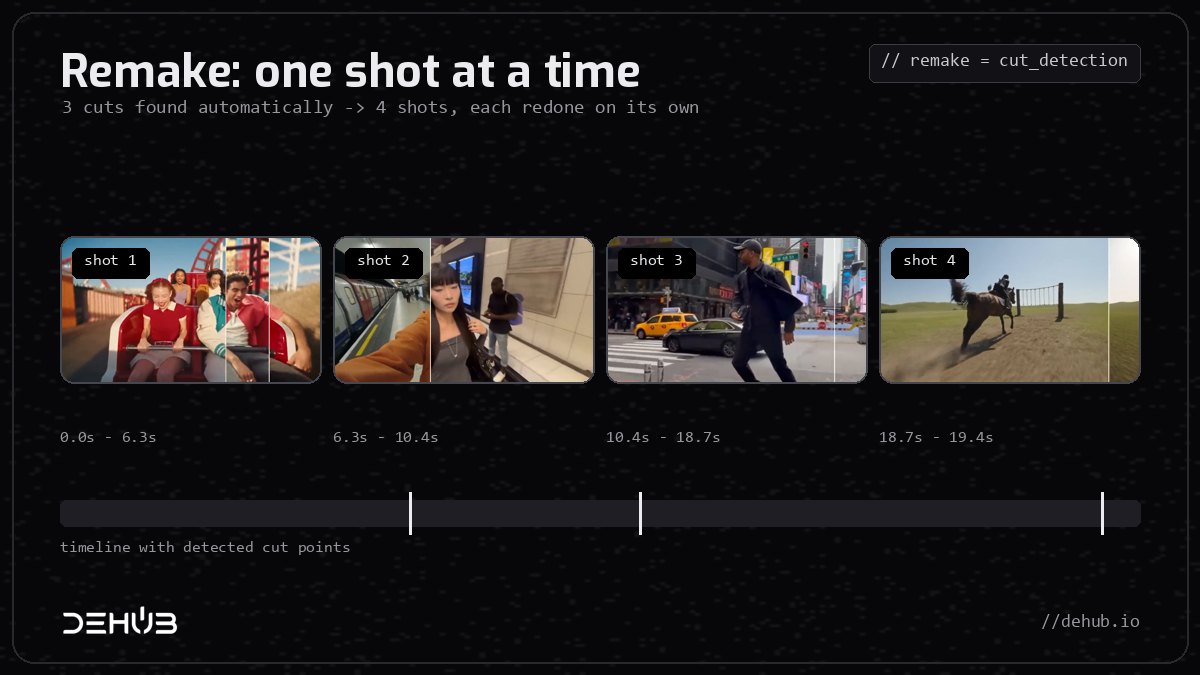
- Remake, para edições com várias cenas. Envie um clipe com cortes. O Maboroshi encontra os pontos de corte sozinho, ou você os marca (até sete), e divide o clipe em até oito cenas. Cada cena recebe sua própria direção, e você pode refazer qualquer cena até cinco vezes sem mexer no resto. Quando estiver satisfeito, as cenas são unidas de novo na ordem com o áudio original, e a união não custa nada a mais. Cada cena custa o mesmo que uma troca normal no Kling.
- Kling O3 Character Swap, para qualquer coisa no quadro. No DeHub Creator, esse modelo troca personagens, produtos ou cenários no seu clipe a partir de até quatro imagens. Use para mudar o carro, a bebida na mão de alguém, a jaqueta ou a rua ao fundo.
- Seedance 2.0 restyle, para a cena inteira. Também no Creator, envie um vídeo e descreva um visual novo, como noite, massinha ou uma nevasca. O movimento fica e o mundo inteiro em volta muda.
A imagem abaixo mostra a detecção de cortes do Remake no nosso próprio vídeo promocional. Ele encontrou três cortes automaticamente e dividiu o clipe em quatro cenas.
Por que conseguimos fazer por menos
Todas as etapas acima, exceto a renderização, são baratas de rodar. Normalização, separação do áudio, profundidade, máscara e malha facial rodam no nosso próprio servidor e custam centavos. O dinheiro está no modelo de renderização final, cobrado por segundo. Por isso nós:
- Cobramos por segundo. Um clipe de 5 segundos não é cobrado como um de 15.
- Pulamos a etapa paga quando ela não é necessária. A rota Kling não tem taxa de preparação nem taxa HD separada.
- Fazemos você conferir antes. Você aprova a máscara antes de pagar, então menos renderizações pagas vão para o lixo.
- Não cobramos assinatura. Você paga pelo clipe que está na sua frente, e o crédito que você recarrega na DeHub nunca expira.
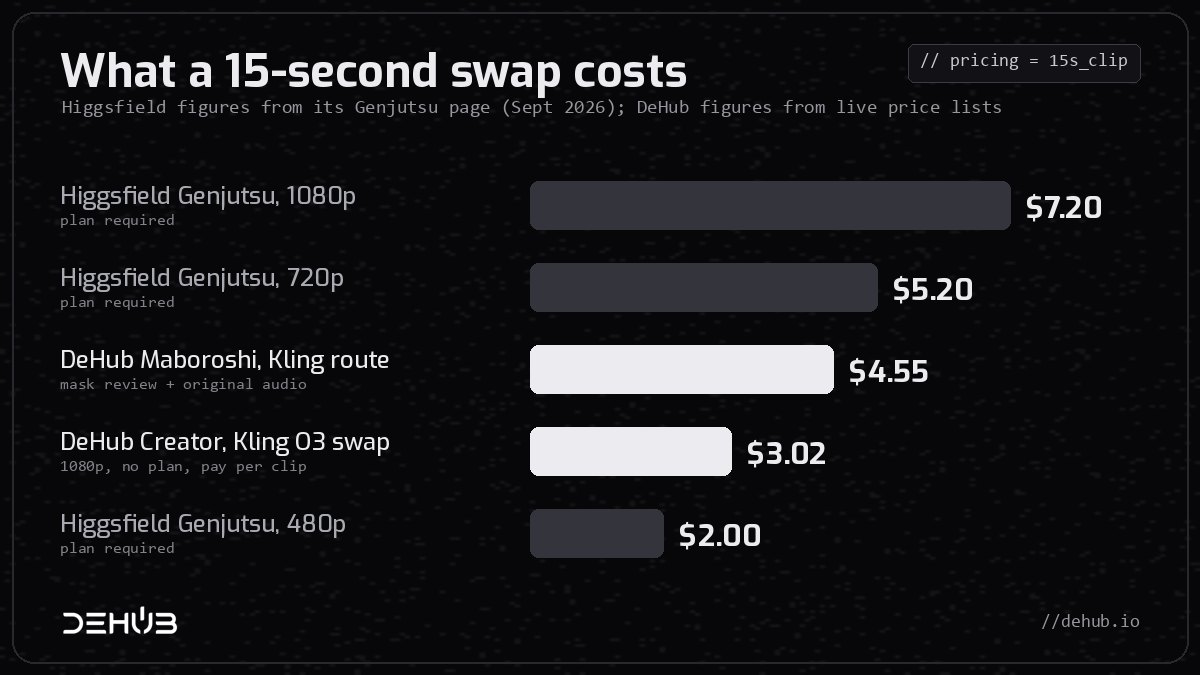
Um clipe de 15 segundos, lado a lado:
- Higgsfield Genjutsu, 1080p: 144 créditos, cerca de $7.20, plano obrigatório
- Higgsfield Genjutsu, 720p: 104 créditos, cerca de $5.20, plano obrigatório
- DeHub Maboroshi, rota Kling, com revisão de máscara e áudio original: $4.55
- DeHub Creator, Kling O3 Character Swap em 1080p: $3.02
- Higgsfield Genjutsu, 480p: 40 créditos, cerca de $2.00, plano obrigatório
Clipes mais curtos, onde a cobrança por segundo vence:
- 5 segundos: Maboroshi $1.75, troca no Creator $1.01
- 10 segundos: Maboroshi $3.15, troca no Creator $2.02
- 15 segundos: Maboroshi $4.55, troca no Creator $3.02
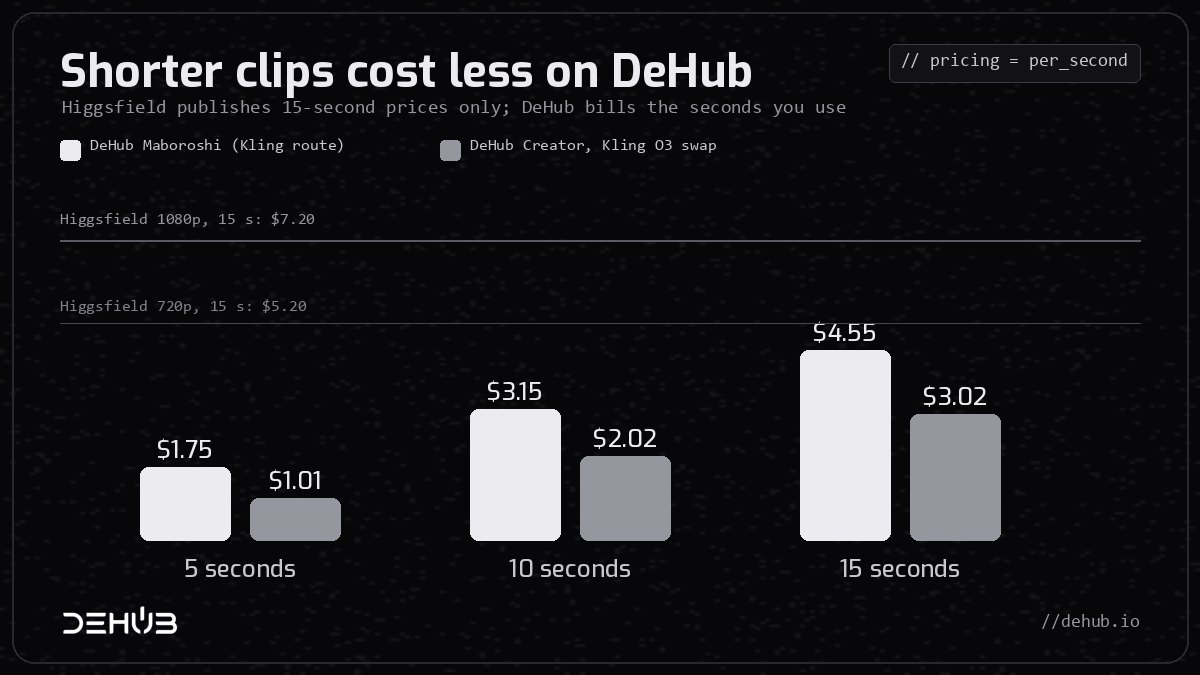
Dois avisos honestos. Se você só precisa de um clipe em 480p e já paga um plano do Higgsfield, os $2.00 dele saem mais baratos. E a nossa rota Seedance Premium em 1080p completo custa bem mais que o Higgsfield, cerca de $31 por 15 segundos, porque cobra cada segundo de entrada e de saída perto do que o modelo nos custa. Detalhamos isso no nosso guia de alternativa ao Higgsfield Genjutsu.
Edite, publique e ganhe com isso
O Higgsfield para no botão de download. Na DeHub, o clipe é um ponto de partida, não o fim do trabalho.
O editor de vídeo integrado. O editor de vídeo da DeHub roda no navegador e no app da DeHub. É uma linha do tempo multipista de verdade, não um simples cortador. Coloque seu clipe do Maboroshi ao lado das outras imagens e depois:
- Corte nas mudanças de cena e nas batidas da música.
- Adicione legendas e traduza uma faixa de legendas inteira para outro idioma.
- Remova fundos.
- Gere uma trilha sonora ou efeitos sonoros.
- Grave a tela ou a sua voz direto na linha do tempo.
Os projetos ficam salvos na nuvem com histórico de versões, e você pode compartilhar uma montagem para receber comentários com marcação de tempo.
O app social em volta. A DeHub é uma rede social além de um estúdio, então uma edição pronta vai direto do editor para um post ou um Short. Lá, os espectadores podem te dar gorjetas, e suas visualizações contam para as recompensas de watch-to-earn. Espectadores de outros idiomas podem ativar uma dublagem automática. A DeHub segue ampliando o feed, os Shorts, as transmissões ao vivo e os agentes de IA que podem postar com agendamento.
Uma única conta cobre o ciclo todo: faça a troca, monte a edição, publique e receba por isso.
Experimente
- Abra dehub.io/creator/maboroshi para trocar um sujeito, ou escolha o Kling O3 Character Swap no DeHub Creator para mudar qualquer coisa no quadro.
- Envie um clipe curto com som e uma ou duas imagens de referência nítidas.
- Confira a máscara, aprove e renderize. O preço aparece em dólares antes de você pagar.
- Abra o resultado no editor de vídeo, finalize sua montagem e publique no seu feed.
Perguntas frequentes
Como funciona o Higgsfield Genjutsu?
O Higgsfield não publica o seu pipeline. Efeitos assim são feitos medindo primeiro o clipe original: a taxa de quadros, o som, a profundidade, o contorno do sujeito e a malha facial. Depois, um modelo de referência para vídeo ou de edição de vídeo renderiza de novo só o sujeito, e o áudio original volta no final. O Maboroshi roda exatamente essa cadeia, e este guia mostra cada etapa.
Quais modelos a edição no estilo Genjutsu usa?
No Maboroshi: Demucs para o áudio, Video Depth Anything para a profundidade, SAM 3 Video para a máscara, MediaPipe Face Landmarker para o rosto e Seedance 2.5 reference-to-video ou Kling O3 video-to-video edit para a renderização.
O Maboroshi é mais barato que o Higgsfield Genjutsu?
Em 720p e 1080p, sim. Um clipe de 15 segundos custa $4.55 na rota Kling do Maboroshi e $3.02 com o Kling O3 Character Swap do Creator, contra cerca de $5.20 e $7.20 no Higgsfield. Nenhuma das opções da DeHub exige assinatura. A opção de 480p do Higgsfield, por cerca de $2.00, é mais barata se você já tem um plano.
O que é o Higgsfield Katana, e a DeHub tem algo parecido?
O Katana é a habilidade do Higgsfield, usada em chat, para reconstruir uma edição de referência com suas próprias pessoas, produtos ou roupas. Na DeHub, o Remake reconstrói clipes com várias cenas cena por cena, o Kling O3 Character Swap troca personagens, produtos ou cenários, e o Seedance 2.0 muda o estilo de uma cena inteira. As três ferramentas são cobradas por clipe.
Posso mudar o fundo ou objetos, e não só a pessoa?
Pode. Use o Kling O3 Character Swap no DeHub Creator para trocar produtos ou cenários a partir de imagens de referência, ou o Seedance 2.0 para mudar o estilo do clipe inteiro com um prompt. O Maboroshi em si mantém o fundo exatamente como filmado, que é o que você quer para uma troca de sujeito limpa.
O áudio original é preservado?
Sim. Nas duas rotas do Maboroshi, a faixa original completa é copiada de volta para o clipe pronto, intacta.
As letras miúdas
Os números do Genjutsu do Higgsfield vêm da página do Genjutsu, verificada em setembro de 2026. Os detalhes do Katana vêm do artigo do Higgsfield sobre o Katana de 12 de outubro de 2026. O Higgsfield cobra em créditos e muda os planos com frequência, então confira os preços atuais antes de comparar. Os preços da DeHub são os valores de varejo no momento em que este texto foi escrito, e o preço mostrado antes de cada etapa é sempre o preço que você paga. A imagem de profundidade da etapa 3 foi feita com um modelo de profundidade de quadro único, como ilustração. O Maboroshi em si usa o Video Depth Anything.