Jak działa Higgsfield Genjutsu? I jak Maboroshi robi to samo taniej (2026)
By DeHub Team — 2026-10-24
Higgsfield Genjutsu bierze prawdziwe wideo i podmienia w nim jedną rzecz: osobę, zwierzaka, produkt, strój. Ruch kamery, tempo i tło zostają dokładnie takie, jak je nagrano. Higgsfield nie mówi, jak to działa, więc większość ludzi zakłada, że to jeden tajny model.
Tak nie jest. Po rozebraniu na części edycja w stylu Genjutsu to łańcuch ośmiu kroków, a prawie każde ogniwo to dobrze znany otwarty model. Odbudowaliśmy ten łańcuch jako Maboroshi w DeHub Creator. Uruchamiając go samodzielnie, zobaczyliśmy, gdzie naprawdę idą koszty, i dlatego możemy brać mniej.
Ten poradnik przechodzi przez każdy krok z prawdziwą klatką z każdego z nich. Potem omawia zmianę całej sceny, koszt każdej opcji i to, co dzieje się z klipem po jego powstaniu.
Co robi Higgsfield Genjutsu
Według strony Genjutsu od Higgsfield dostajesz dwa tryby:
- Motion Transfer. Ruch z twojego klipu napędza nową postać albo odbudowaną scenę.
- Object Swap. Jeden wskazany element zostaje podmieniony, a reszta ujęcia zostaje na miejscu. Przykłady Higgsfield to produkty, rekwizyty i stroje.
Wgrywasz jeden klip o długości od 4 do 30 sekund, dodajesz do 30 obrazów referencyjnych i wybierasz jeden z ponad 30 presetów albo piszesz krótki opis. Wynik ma maksymalnie 1080p. Higgsfield nie mówi, jakie modele działają pod spodem.
Widać za to efekt. Ruch kamery zostaje, światło się zgadza, nowy obiekt stoi za właściwymi przedmiotami, a usta ruszają się w rytm głosu. Sam model text-to-video tego nie potrafi, więc coś musi najpierw zmierzyć oryginalny klip. To mierzenie ludzie nazywają inżynierią wsteczną, a dzieli się ono na osiem zadań.
Jak to działa, krok po kroku
Naszym punktem wyjścia był Genjutsu Open Source Workflow autorstwa Sirio Berati na licencji MIT. Pokazał, że efekt da się odbudować z otwartych części. Zostawiliśmy kroki, które mają znaczenie, wymieniliśmy te, które nie były bezpieczne dla prawdziwych użytkowników, i dodaliśmy płatności, weryfikację i odzyskiwanie. Każdy obraz poniżej powstał przez uruchomienie danego kroku na prawdziwym klipie.
Krok 1: Normalizacja klipu
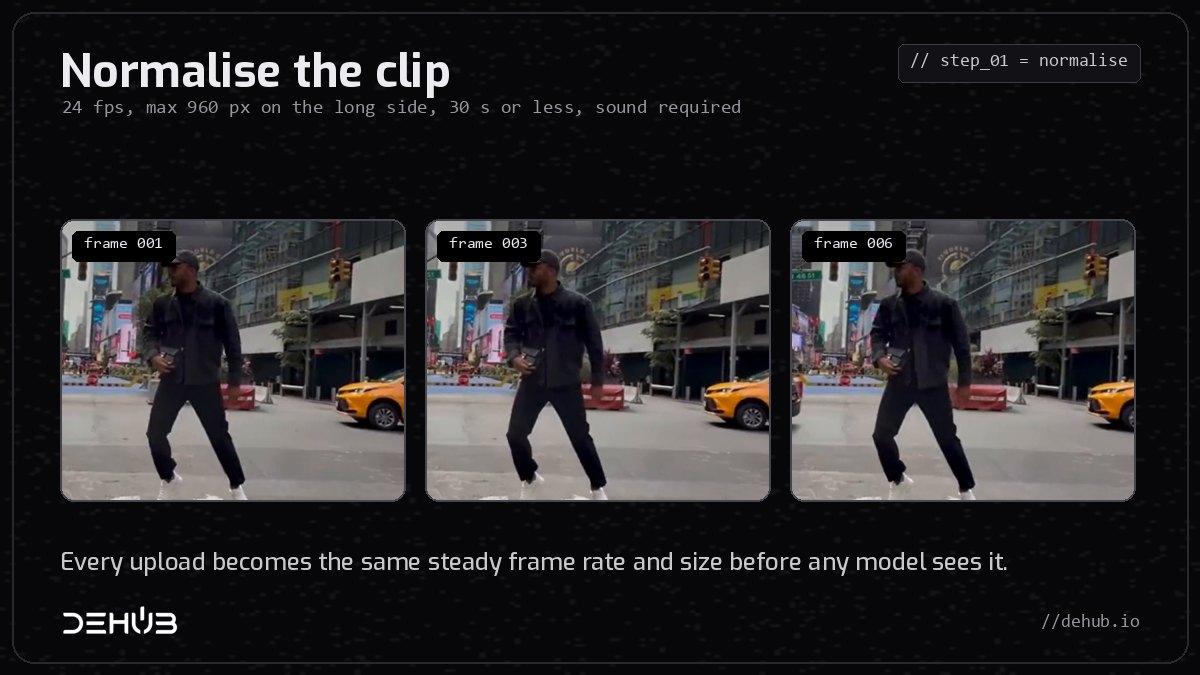
Każde wgranie jest konwertowane do stałych 24 klatek na sekundę i skalowane do maksymalnie 960 pikseli na dłuższym boku. Nagrania z telefonu często mają zmienną liczbę klatek, przez co model rozjeżdża się z synchronizacją. Stała liczba klatek i stały rozmiar dają każdemu kolejnemu krokowi tę samą siatkę i sprawiają, że przetwarzanie jest szybkie i tanie.
Klip musi mieć 30 sekund lub mniej i musi mieć ścieżkę dźwiękową. Na ścieżce Kling w Maboroshi musi mieć od 3 do 15 sekund i co najmniej 720 pikseli z każdej strony.
Krok 2: Zdjęcie ścieżki dźwiękowej
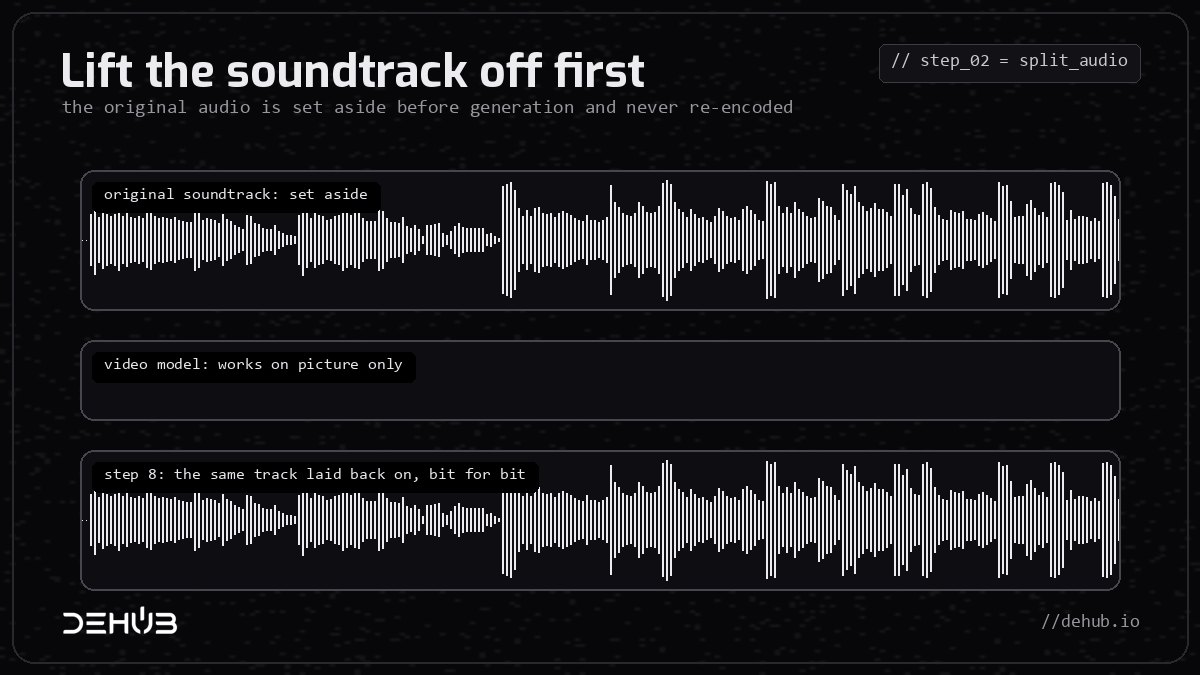
Dźwięk jest zdejmowany, zanim zacznie się jakakolwiek generacja. Demucs, otwarty model, oddziela głos od muzyki, więc model wideo dostaje tylko to, czego potrzebuje. Pełna oryginalna ścieżka jest odkładana na bok, nietknięta.
Dlatego gotowy klip brzmi dokładnie jak oryginał. Modele wideo słabo radzą sobie z dźwiękiem: zmieniają jego tempo, rozmazują go albo wymyślają nowe dźwięki. Dlatego oryginalna ścieżka w ogóle nie przechodzi przez model.
Krok 3: Mapa głębi
Model głębi szacuje, jak daleko od kamery jest każdy piksel, klatka po klatce. Maboroshi używa Video Depth Anything, który powstał z myślą o wideo i jest stabilny między klatkami. Obraz poniżej zrobiono mniejszym modelem głębi dla pojedynczych klatek, ale idea jest ta sama: blisko jest jasno, daleko jest ciemno.
Głębia pozwala nowemu obiektowi stanąć w tym samym miejscu, w odpowiednim rozmiarze, przed taksówkami i za latarnią. Bez niej podmienione postacie unoszą się w powietrzu.
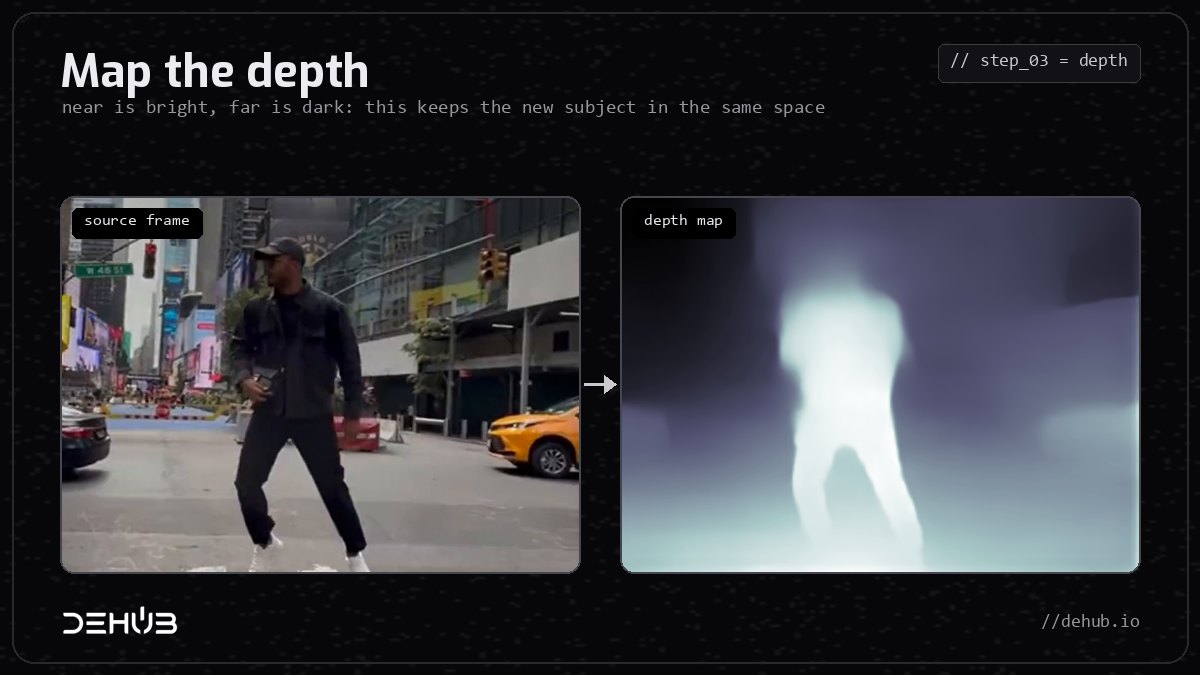
Krok 4: Wycięcie obiektu
SAM 3 Video, czyli Segment Anything od Meta dla wideo, znajduje wskazany obiekt (na przykład „person”) i rysuje wokół niego czystą maskę w każdej klatce. Drobne fragmenty na krawędziach są automatycznie czyszczone, żeby zabłąkane piksele nie myliły modelu. Maska mówi rendererowi dokładnie, co podmienić, a czego nie ruszać.
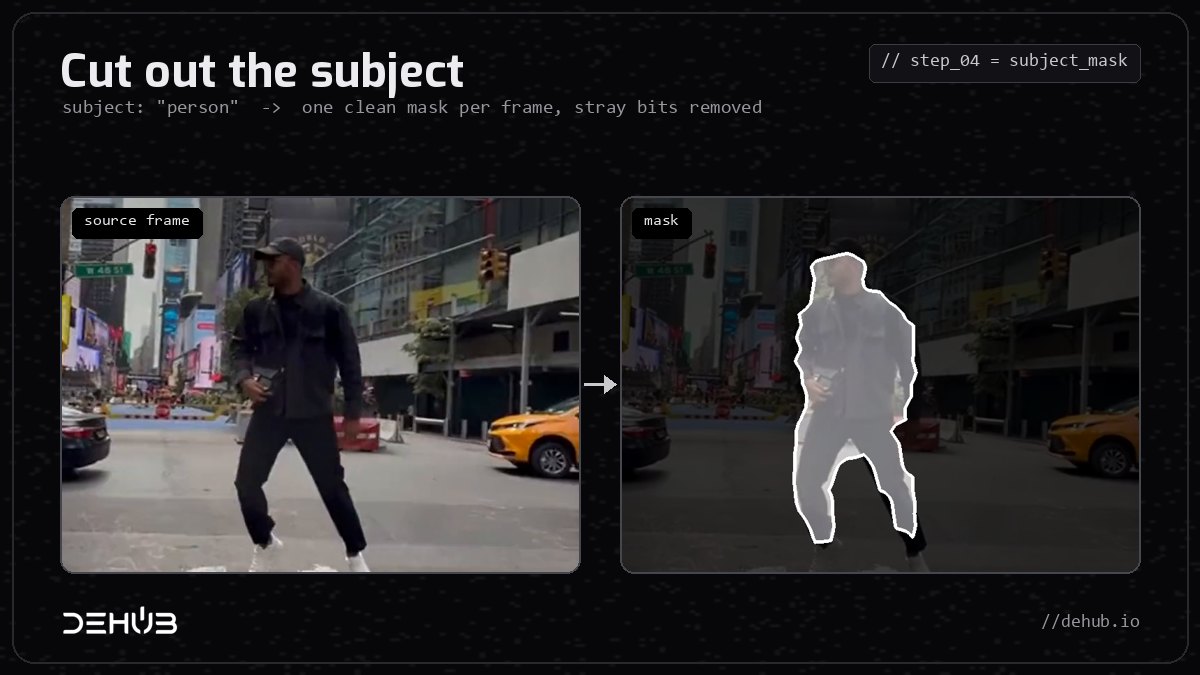
Krok 5: Śledzenie twarzy
MediaPipe Face Landmarker nakłada na każdą twarz siatkę z 478 punktów, w każdej klatce. Ta siatka przenosi mimikę, obroty głowy i ruch ust na nową postać. Dlatego podmieniony kot nadal może wyglądać, jakby śpiewał tekst.
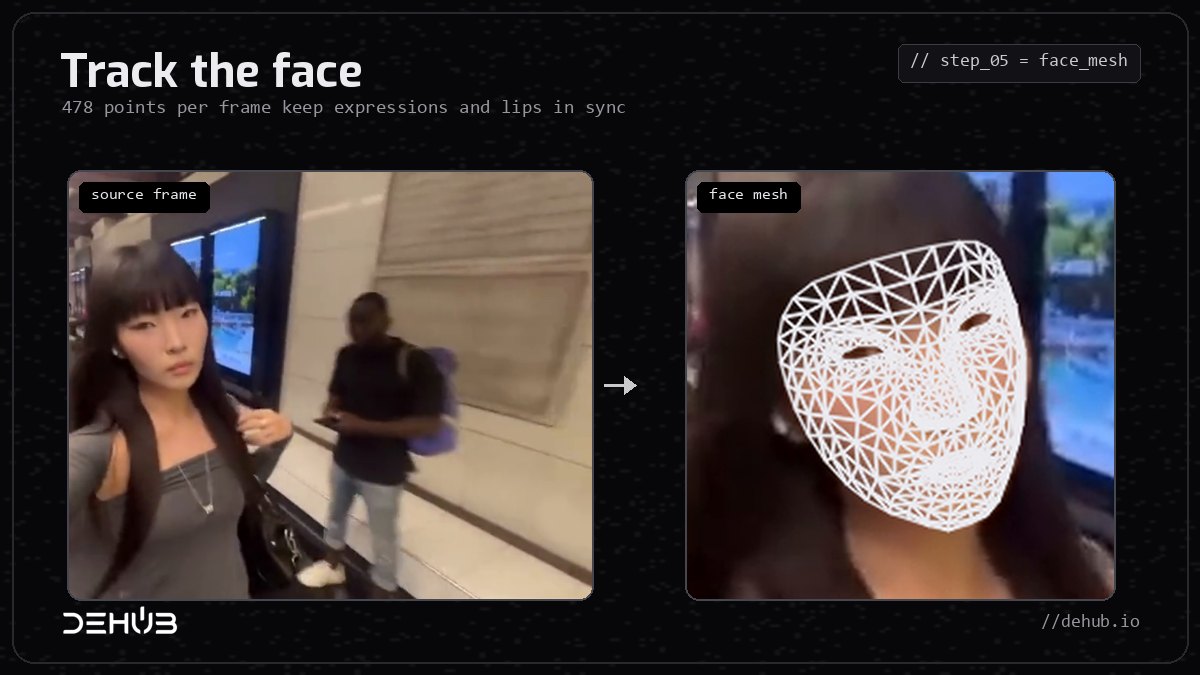
Krok 6: Sprawdzasz wideo kontrolne
Głębia, maska i siatka twarzy są łączone w jedno wideo kontrolne, które widzisz, zanim zacznie się coś drogiego. Jeśli wycięcie jest złe, zatrzymujesz się w tym miejscu i nie płacisz nic więcej. Finalny render działa tylko na dokładnie tej wersji, którą zatwierdziłeś. Zmień klip, obiekt lub referencję, a zatwierdzenie się resetuje.
Higgsfield nie pokazuje tego etapu. Uważamy, że jest najbardziej przydatny, bo zła maska to główny powód, dla którego płatny render wraca źle zrobiony.
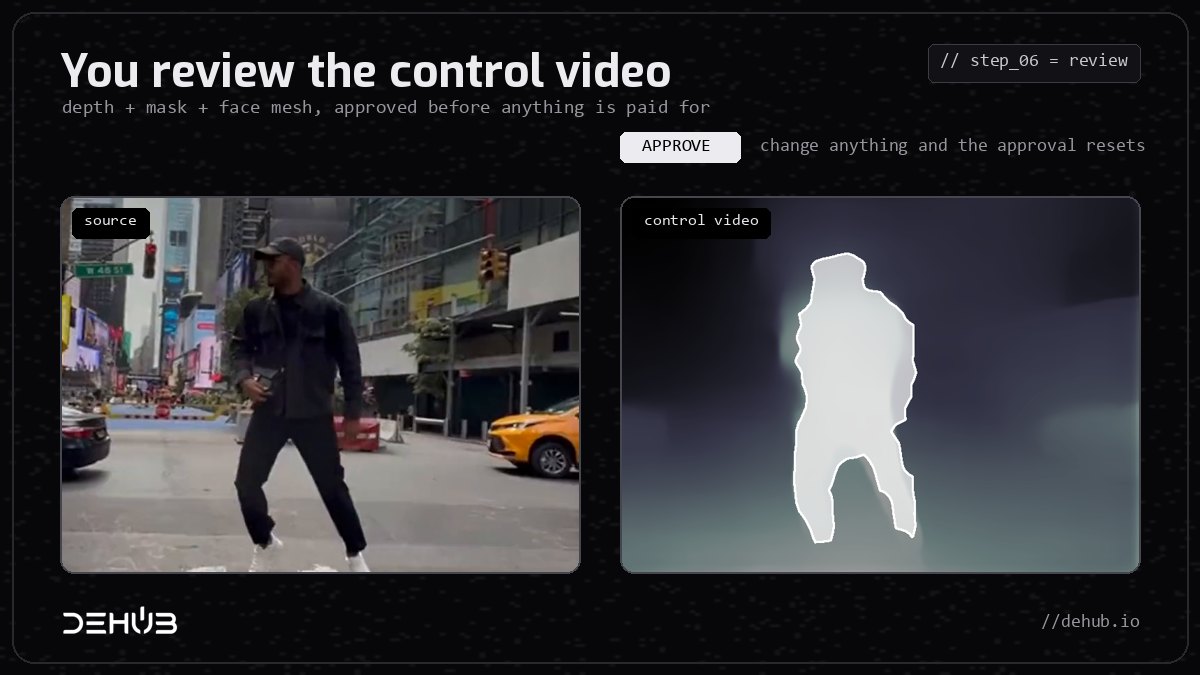
Krok 7: Render
Render działa na jeden z dwóch sposobów:
- Ścieżka Seedance Premium. Seedance 2.5 reference-to-video renderuje tani szkic z wideo kontrolnego i twoich obrazów referencyjnych. Za 1080p płacisz tylko wtedy, gdy szkic ci się podoba, a finał powstaje z tego samego szkicu, więc dostajesz to, co zatwierdziłeś.
- Ścieżka Kling. Oryginalny klip i jeden lub dwa obrazy postaci trafiają do Kling O3 video-to-video edit w jednym przebiegu. Bez przygotowania i bez szkicu. Jest szybciej i taniej, i to nasza domyślna opcja dla większości podmian.
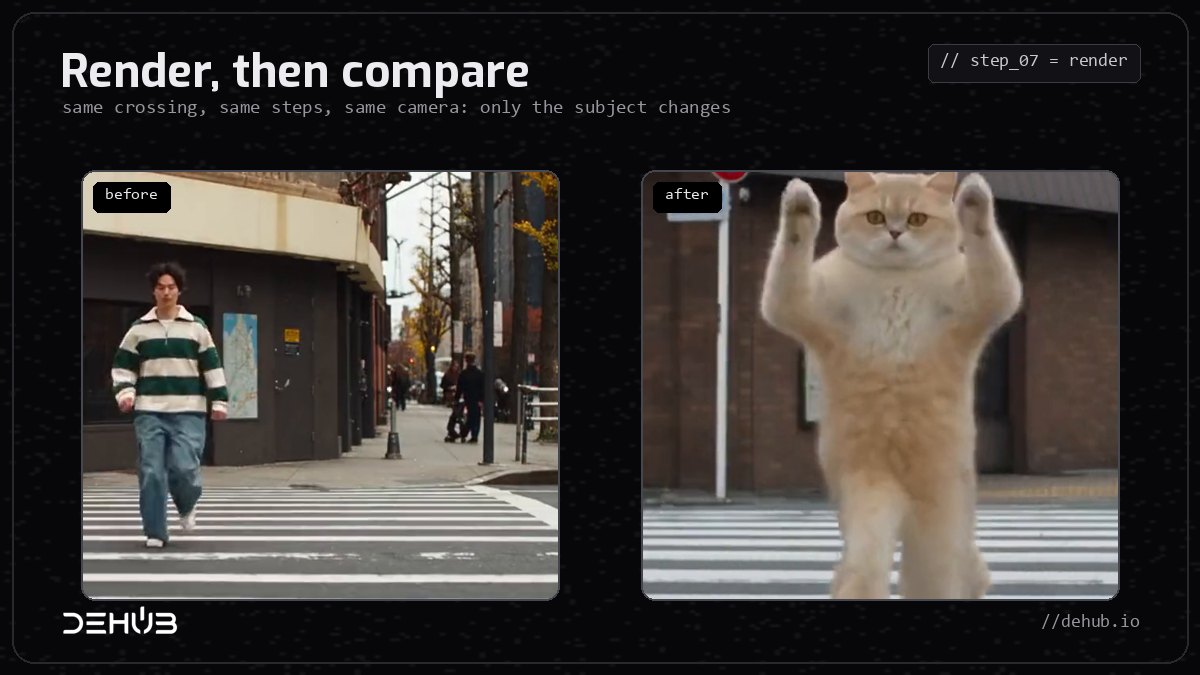
Krok 8: Przywrócenie oryginalnego dźwięku
Obie ścieżki kończą się nałożeniem z powrotem pełnej oryginalnej ścieżki audio, skopiowanej, a nie ponownie zakodowanej. Głos, rytm i tempo są dokładnie takie, jak je nagrałeś, i to pierwsza rzecz, którą ludzie zauważają przy porównaniu wyników obok siebie.
Zmiana dowolnej sceny lub czegokolwiek w niej
12 października 2026 roku Higgsfield uruchomił Katana, umiejętność montażową działającą w czacie AI. Dajesz jej wideo referencyjne albo preset z biblioteki oraz do pięciu zdjęć ludzi, produktów lub ubrań. Odbudowuje cały montaż wokół nich, zachowując strukturę ujęć i tempo referencji, i renderuje ponownie tylko ujęcia, które poprawisz. Wymaga aktywnego planu Higgsfield i zużywa jego kredyty.
DeHub robi to samo trzema narzędziami, każde z ceną za klip:
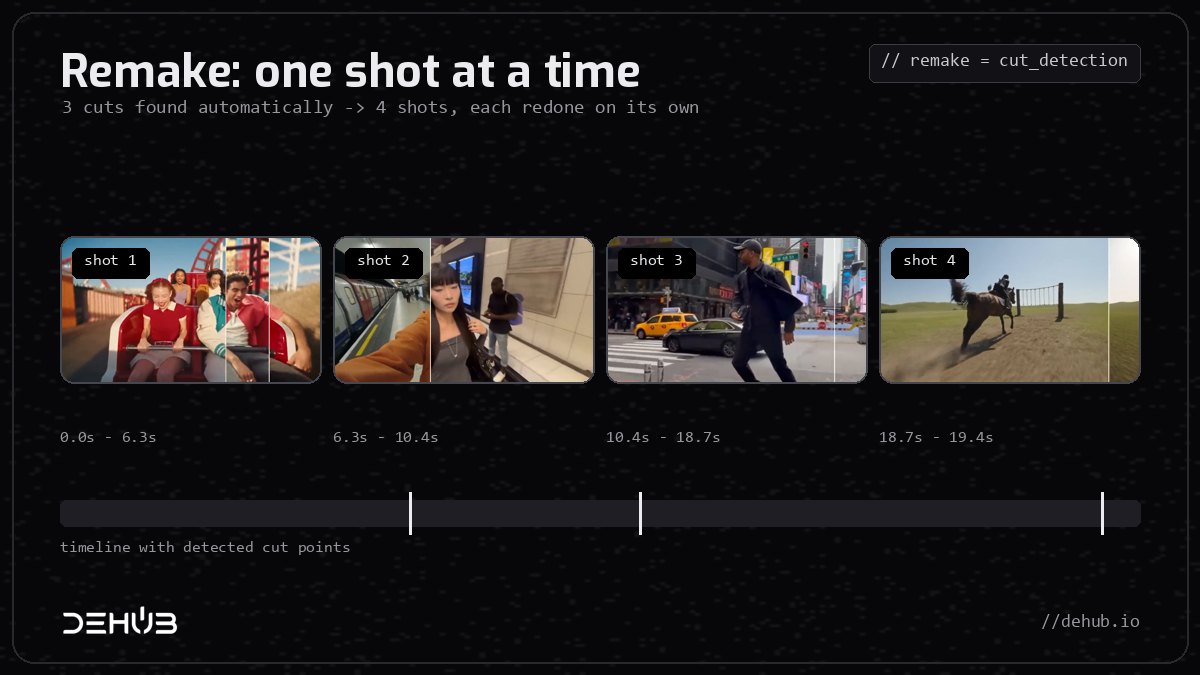
- Remake do montaży z wieloma ujęciami. Wgraj klip z cięciami. Maboroshi sam znajduje punkty cięcia albo oznaczasz je ty (do siedmiu), i dzieli klip na maksymalnie osiem ujęć. Każde ujęcie dostaje własną reżyserię, a każde pojedyncze ujęcie możesz powtórzyć do pięciu razy bez ruszania reszty. Gdy jesteś zadowolony, ujęcia są sklejane z powrotem w kolejności z oryginalnym dźwiękiem, a sklejanie nic nie kosztuje. Każde ujęcie kosztuje tyle, co zwykła podmiana Kling.
- Kling O3 Character Swap do wszystkiego w kadrze. W DeHub Creator ten model podmienia postacie, produkty lub scenerię w twoim klipie na podstawie maksymalnie czterech obrazów. Użyj go, żeby zmienić samochód, napój w czyjejś dłoni, kurtkę albo ulicę w tle.
- Restyle Seedance 2.0 dla całej sceny. Również w Creator wgraj wideo i opisz nowy wygląd, na przykład noc, plastelinową animację albo śnieżycę. Ruch zostaje, a cały świat wokół się zmienia.
Obraz poniżej pokazuje wykrywanie cięć w Remake na naszym własnym filmie promocyjnym. Automatycznie znalazł trzy cięcia i podzielił klip na cztery ujęcia.
Dlaczego możemy to robić taniej
Każdy krok powyżej oprócz renderu jest tani w działaniu. Normalizacja, rozdzielenie dźwięku, głębia, maskowanie i siatka twarzy działają na naszym własnym serwerze i kosztują grosze. Pieniądze idą na finalny model renderujący, rozliczany za sekundę. Dlatego:
- Rozliczamy za sekundę. Klip 5-sekundowy nie kosztuje tyle, co 15-sekundowy.
- Pomijamy płatny krok, gdy nie jest potrzebny. Ścieżka Kling nie ma opłaty za przygotowanie ani osobnej opłaty za HD.
- Najpierw każemy ci sprawdzić. Zatwierdzasz maskę przed zapłatą, więc mniej płatnych renderów ląduje w koszu.
- Bez subskrypcji. Płacisz za klip, który masz przed sobą, a kredyt doładowany w DeHub nigdy nie wygasa.
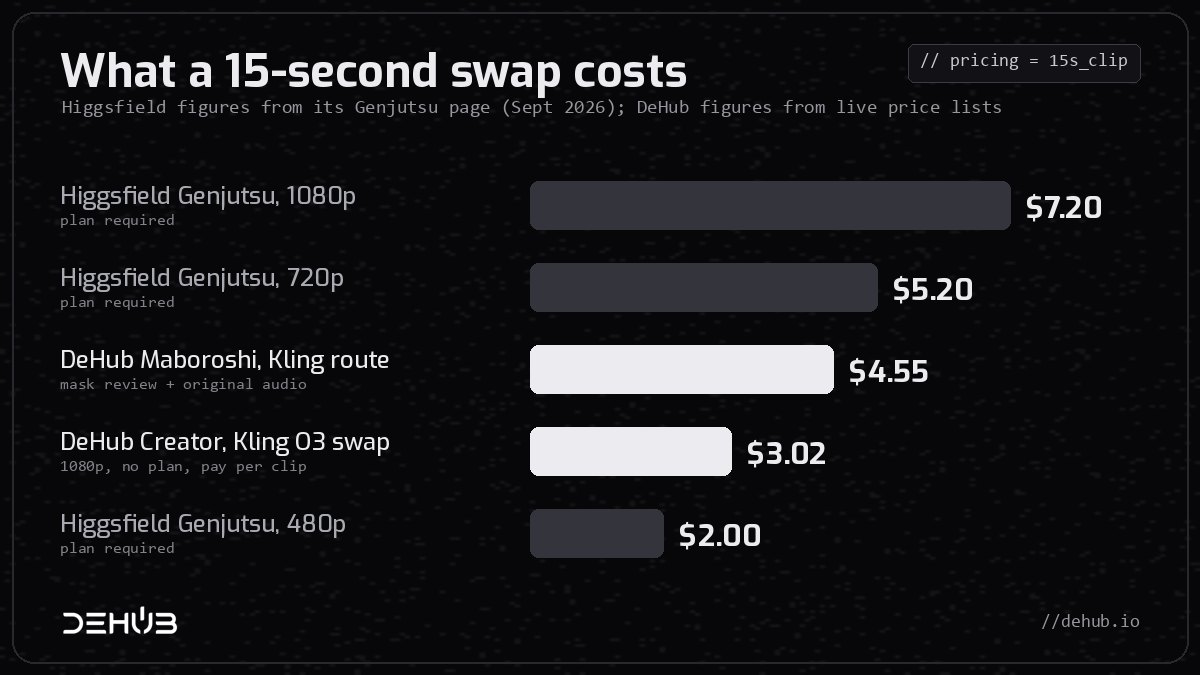
Klip 15-sekundowy, obok siebie:
- Higgsfield Genjutsu, 1080p: 144 kredyty, około $7.20, wymagany plan
- Higgsfield Genjutsu, 720p: 104 kredyty, około $5.20, wymagany plan
- DeHub Maboroshi, ścieżka Kling, z weryfikacją maski i oryginalnym dźwiękiem: $4.55
- DeHub Creator, Kling O3 Character Swap w 1080p: $3.02
- Higgsfield Genjutsu, 480p: 40 kredytów, około $2.00, wymagany plan
Krótsze klipy, gdzie wygrywa rozliczanie za sekundę:
- 5 sekund: Maboroshi $1.75, podmiana w Creator $1.01
- 10 sekund: Maboroshi $3.15, podmiana w Creator $2.02
- 15 sekund: Maboroshi $4.55, podmiana w Creator $3.02
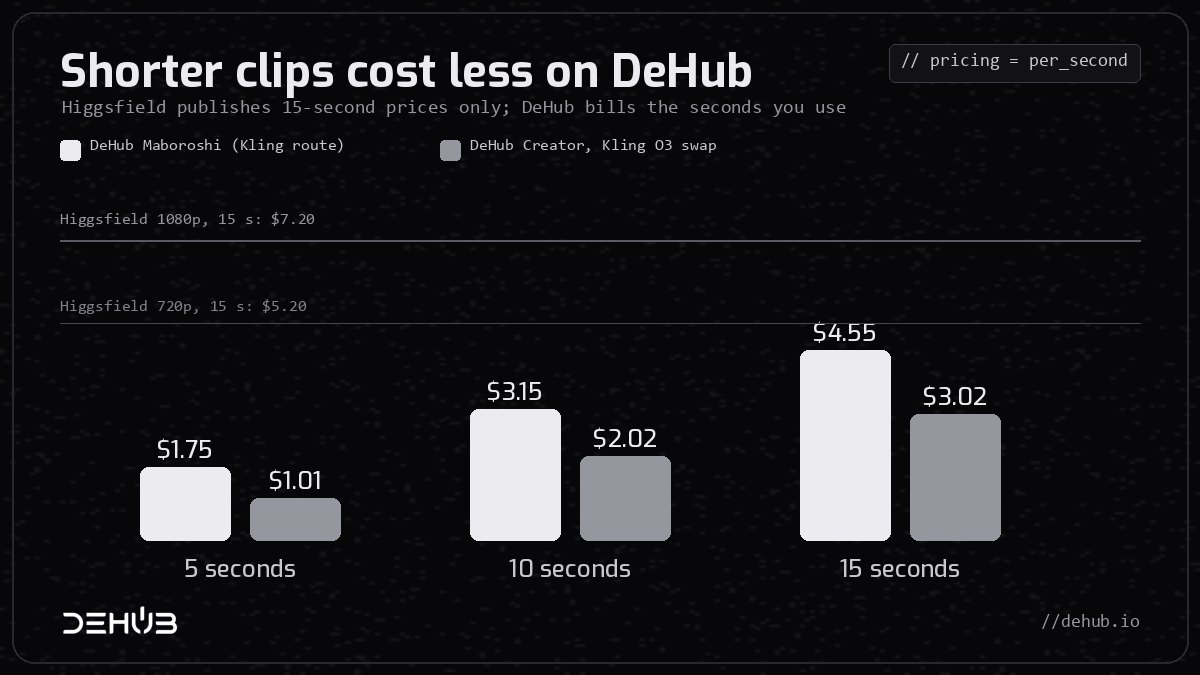
Dwa uczciwe zastrzeżenia. Jeśli potrzebujesz tylko klipu w 480p i już płacisz za plan Higgsfield, jego $2.00 jest tańsze. A nasza ścieżka Seedance Premium w pełnym 1080p kosztuje znacznie więcej niż Higgsfield, około $31 za 15 sekund, bo rozlicza każdą sekundę wejścia i wyjścia blisko tego, ile model kosztuje nas. Rozpisujemy to w naszym poradniku o alternatywie dla Higgsfield Genjutsu.
Zmontuj, opublikuj, zarabiaj
Higgsfield kończy się na przycisku pobierania. W DeHub klip jest punktem wyjścia, a nie końcem pracy.
Wbudowany edytor wideo. Edytor wideo DeHub działa w przeglądarce i w aplikacji DeHub. To prawdziwa wielościeżkowa oś czasu, a nie suwak do przycinania. Wrzuć klip z Maboroshi obok innych nagrań, a potem:
- Tnij na zmianach scen i uderzeniach muzyki.
- Dodawaj napisy i tłumacz całą ścieżkę napisów na inny język.
- Usuwaj tła.
- Generuj ścieżkę dźwiękową lub efekty dźwiękowe.
- Nagrywaj ekran lub głos prosto na oś czasu.
Projekty zapisują się w chmurze z historią wersji, a montaż możesz udostępnić do komentarzy z oznaczeniem czasu.
Aplikacja społecznościowa wokół. DeHub to sieć społecznościowa i studio jednocześnie, więc gotowy montaż trafia prosto z edytora do posta lub Shorta. Tam widzowie mogą dawać ci napiwki, a twoje wyświetlenia liczą się do nagród watch-to-earn. Widzowie mówiący innymi językami mogą włączyć automatyczny dubbing. DeHub stale rozwija feed, Shorts, transmisje na żywo i agentów AI, którzy mogą publikować według harmonogramu.
Jedno konto obejmuje całą pętlę: zrób podmianę, zmontuj ją, opublikuj i dostań za nią zapłatę.
Wypróbuj
- Otwórz dehub.io/creator/maboroshi, żeby podmienić obiekt, albo wybierz Kling O3 Character Swap w DeHub Creator, żeby zmienić cokolwiek w kadrze.
- Wgraj krótki klip z dźwiękiem i jeden lub dwa wyraźne obrazy referencyjne.
- Sprawdź maskę, zatwierdź i wyrenderuj. Cena jest pokazana w dolarach przed zapłatą.
- Otwórz wynik w edytorze wideo, dokończ montaż i opublikuj go w swoim feedzie.
Najczęściej zadawane pytania
Jak działa Higgsfield Genjutsu?
Higgsfield nie publikuje swojego pipeline’u. Takie efekty buduje się, najpierw mierząc oryginalny klip: liczbę klatek, dźwięk, głębię, kontur obiektu i siatkę twarzy. Potem model reference-to-video lub video-edit renderuje ponownie tylko obiekt, a oryginalny dźwięk wraca na końcu. Maboroshi uruchamia dokładnie ten łańcuch, a ten poradnik pokazuje każdy krok.
Jakich modeli używa edycja w stylu Genjutsu?
W Maboroshi: Demucs do dźwięku, Video Depth Anything do głębi, SAM 3 Video do maski, MediaPipe Face Landmarker do twarzy oraz Seedance 2.5 reference-to-video lub Kling O3 video-to-video edit do renderu.
Czy Maboroshi jest tańsze niż Higgsfield Genjutsu?
W 720p i 1080p tak. Klip 15-sekundowy kosztuje $4.55 na ścieżce Kling w Maboroshi i $3.02 z Kling O3 Character Swap w Creator, wobec około $5.20 i $7.20 w Higgsfield. Żadna z opcji DeHub nie wymaga subskrypcji. Opcja 480p w Higgsfield, za około $2.00, jest tańsza, jeśli masz już plan.
Czym jest Higgsfield Katana i czy DeHub ma coś podobnego?
Katana to oparta na czacie umiejętność Higgsfield do odbudowy montażu referencyjnego z twoimi ludźmi, produktami lub ubraniami. W DeHub Remake odbudowuje klipy z wieloma ujęciami ujęcie po ujęciu, Kling O3 Character Swap zmienia postacie, produkty lub scenerię, a Seedance 2.0 zmienia styl całej sceny. Wszystkie trzy mają cenę za klip.
Czy mogę zmienić tło lub przedmioty, a nie tylko osobę?
Tak. Użyj Kling O3 Character Swap w DeHub Creator, żeby podmienić produkty lub scenerię na podstawie obrazów referencyjnych, albo Seedance 2.0, żeby zmienić styl całego klipu promptem. Samo Maboroshi zachowuje tło dokładnie takie, jak je nagrano, a tego właśnie chcesz przy czystej podmianie obiektu.
Czy oryginalny dźwięk zostaje?
Tak. Na obu ścieżkach Maboroshi pełna oryginalna ścieżka jest kopiowana z powrotem na gotowy klip, nietknięta.
Drobny druk
Dane o Genjutsu od Higgsfield pochodzą z jego strony Genjutsu sprawdzonej we wrześniu 2026. Szczegóły Katany pochodzą z artykułu Higgsfield o Katanie z 12 października 2026. Higgsfield podaje ceny w kredytach i często zmienia plany, więc sprawdź aktualny cennik przed porównaniem. Ceny DeHub to stawki detaliczne w chwili pisania, a cena pokazana przed każdym krokiem to zawsze cena, którą płacisz. Obraz głębi w kroku 3 powstał dla ilustracji modelem głębi dla pojedynczych klatek. Samo Maboroshi używa Video Depth Anything.