Come funziona Higgsfield Genjutsu? E come Maboroshi fa lo stesso lavoro spendendo meno (2026)
By DeHub Team — 2026-10-24
Higgsfield Genjutsu prende un video reale e ne sostituisce un elemento: una persona, un animale, un prodotto, un outfit. Il movimento di camera, i tempi e lo sfondo restano esattamente come sono stati girati. Higgsfield non spiega come funziona, quindi molti pensano che sia un unico modello segreto.
Non lo è. Una volta smontato, l'editing in stile Genjutsu è una catena di otto passaggi, e quasi ogni anello è un modello open ben noto. Abbiamo ricostruito quella catena come Maboroshi, dentro DeHub Creator. Farla girare noi stessi ci ha mostrato dove vanno davvero i costi, ed è per questo che possiamo chiedere meno.
Questa guida percorre ogni passaggio con un fotogramma reale di ciascuno. Poi spiega come cambiare un'intera scena, quanto costa ogni opzione e cosa succede al tuo clip una volta creato.
Cosa fa Higgsfield Genjutsu
Secondo la pagina Genjutsu di Higgsfield, ci sono due modalità:
- Motion Transfer. Il movimento del tuo clip guida un nuovo personaggio o una scena ricostruita.
- Object Swap. Un elemento che indichi viene sostituito mentre il resto dell'inquadratura resta fermo. Gli esempi di Higgsfield sono prodotti, oggetti di scena e outfit.
Carichi un clip da 4 a 30 secondi, aggiungi fino a 30 immagini di riferimento e scegli uno degli oltre 30 preset oppure scrivi una breve descrizione. L'output arriva fino a 1080p. Higgsfield non dice quali modelli girano sotto.
Quello che puoi vedere è il risultato. Il movimento di camera sopravvive, la luce combacia, il nuovo soggetto sta dietro gli oggetti giusti e la bocca si muove a tempo con la voce. Un modello text-to-video da solo non può farlo, quindi qualcosa deve prima misurare il clip originale. Quella misurazione è la parte che la gente chiama reverse engineering, e si divide in otto lavori.
Come funziona, passo dopo passo
Il nostro punto di partenza è stato il Genjutsu Open Source Workflow di Sirio Berati, con licenza MIT. Ha dimostrato che l'effetto si poteva ricostruire con parti open. Abbiamo tenuto i passaggi che contano, sostituito quelli non sicuri per utenti reali e aggiunto pagamenti, revisione e recupero. Ogni immagine qui sotto è stata creata eseguendo il passaggio su un clip reale.
Passaggio 1: normalizzare il clip
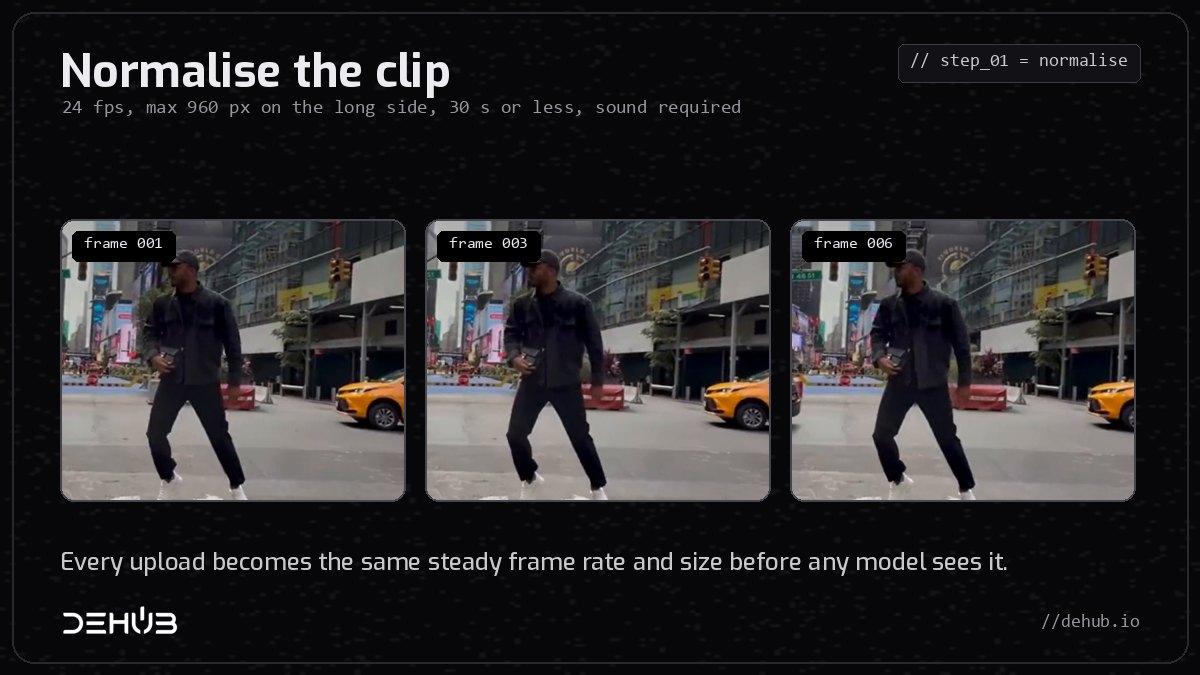
Ogni caricamento viene convertito a 24 fotogrammi al secondo costanti e ridimensionato a massimo 960 pixel sul lato lungo. I video da telefono hanno spesso un frame rate variabile, che fa perdere la sincronia al modello. Una frequenza fissa e una dimensione fissa danno a ogni passaggio successivo la stessa griglia su cui lavorare e mantengono l'elaborazione veloce ed economica.
Il clip deve durare 30 secondi o meno e deve avere una traccia audio. Sulla via Kling di Maboroshi deve durare da 3 a 15 secondi, con almeno 720 pixel per lato.
Passaggio 2: staccare la colonna sonora
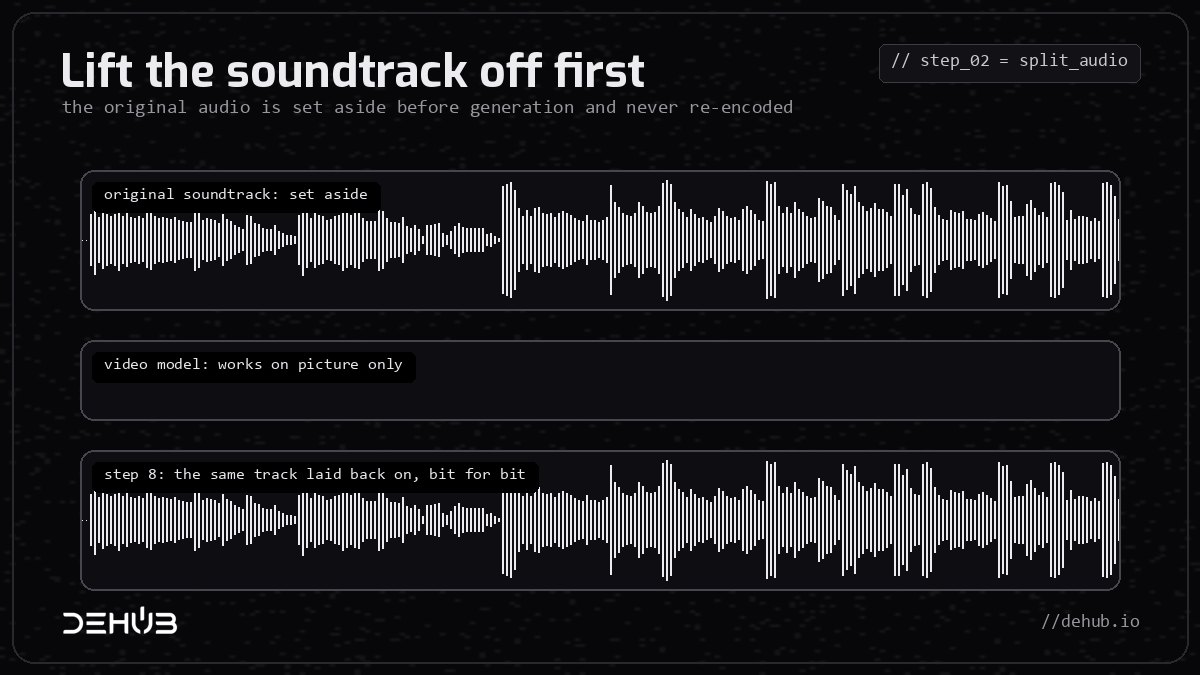
L'audio viene tolto prima di qualsiasi generazione. Demucs, un modello open, separa la voce dalla musica, così al modello video arriva solo ciò che gli serve. La traccia originale completa viene messa da parte, intatta.
È per questo che il clip finito suona esattamente come l'originale. I modelli video sono scarsi con l'audio: lo risincronizzano, lo sbavano o inventano suoni nuovi. Quindi la traccia originale non passa mai dal modello.
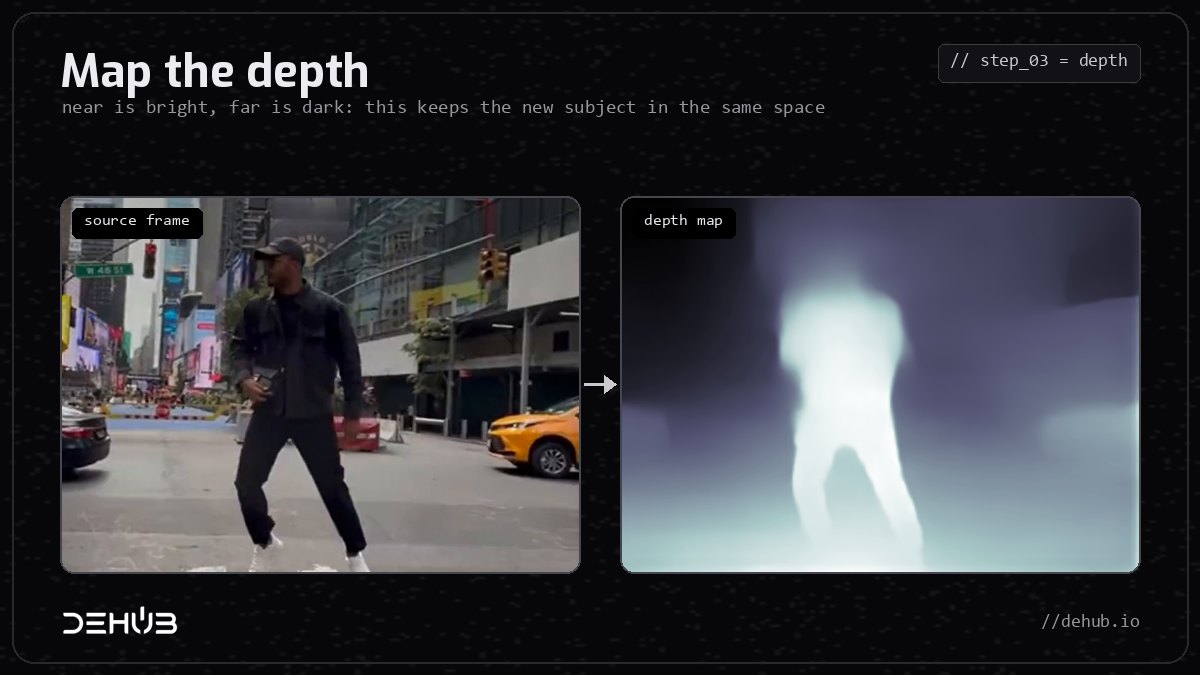
Passaggio 3: mappare la profondità
Un modello di profondità stima quanto ogni pixel è lontano dalla camera, fotogramma per fotogramma. Maboroshi usa Video Depth Anything, pensato per il video e stabile da un fotogramma all'altro. L'immagine qui sotto è stata fatta con un modello di profondità più piccolo a fotogramma singolo, ma l'idea è la stessa: vicino è chiaro, lontano è scuro.
La profondità è ciò che permette al nuovo soggetto di stare nello stesso punto, alla giusta dimensione, davanti ai taxi e dietro il lampione. Senza, i personaggi sostituiti fluttuano.
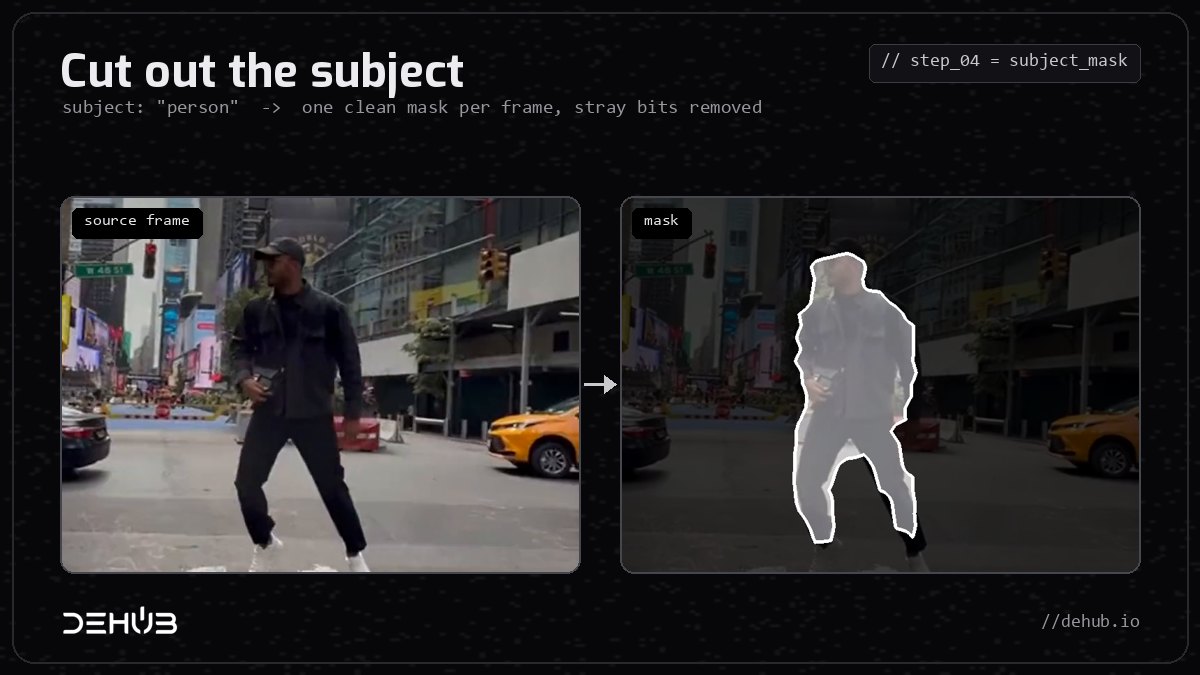
Passaggio 4: ritagliare il soggetto
SAM 3 Video, il Segment Anything di Meta per il video, trova il soggetto che indichi (per esempio «person») e disegna una maschera pulita attorno a esso in ogni fotogramma. I piccoli frammenti sui bordi vengono ripuliti automaticamente così i pixel vaganti non confondono il modello. La maschera dice al renderer esattamente cosa sostituire e cosa lasciare stare.
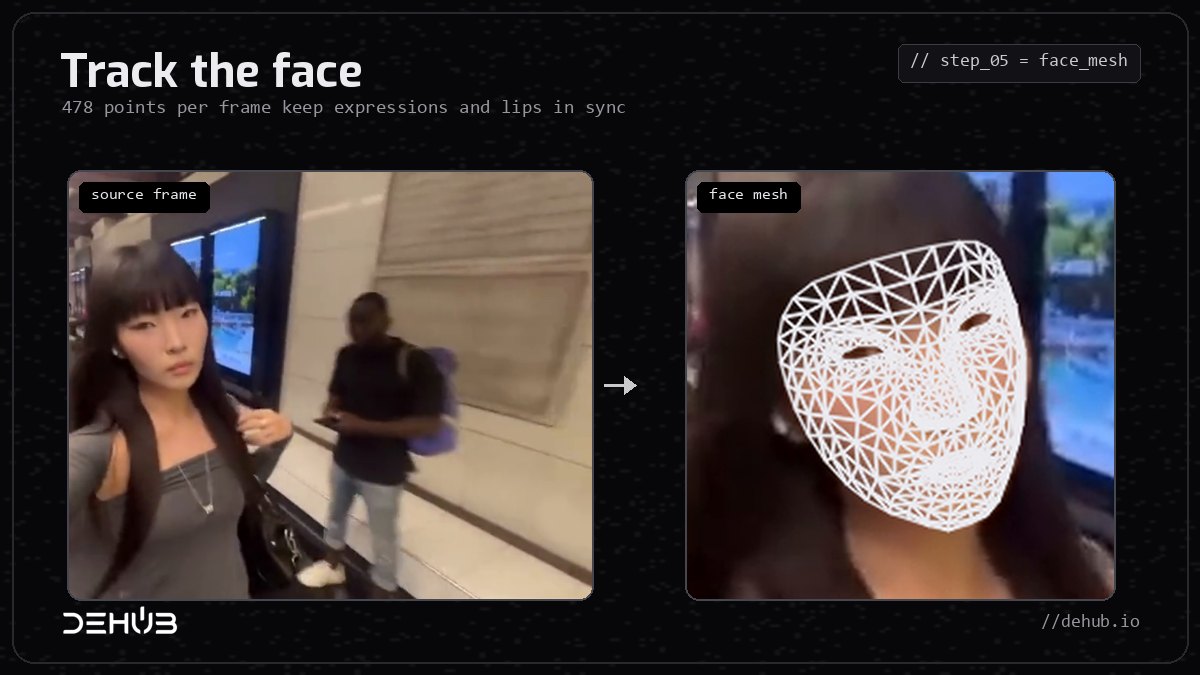
Passaggio 5: tracciare il volto
MediaPipe Face Landmarker traccia una mesh di 478 punti su ogni volto, in ogni fotogramma. Quella mesh porta espressioni, rotazioni della testa e movimento delle labbra sul nuovo personaggio. È per questo che un gatto sostituito può ancora sembrare che stia cantando la battuta.
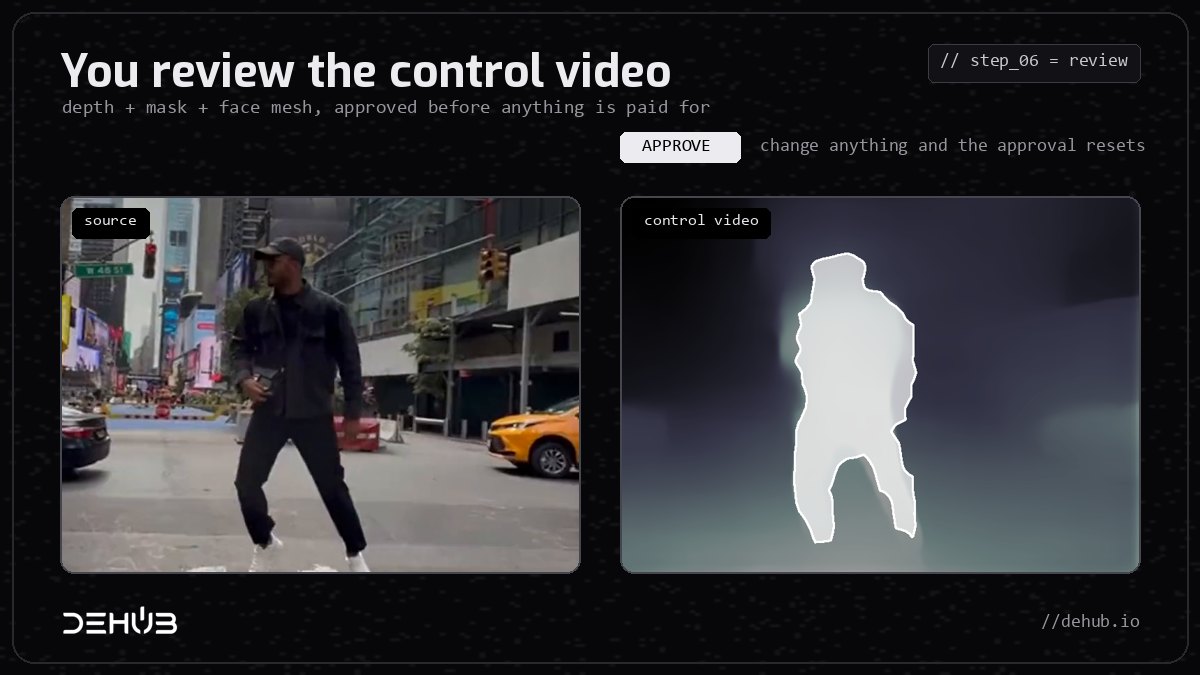
Passaggio 6: controlli il video di controllo
Profondità, maschera e mesh del volto vengono combinate in un unico video di controllo, e lo vedi prima che succeda qualcosa di costoso. Se il ritaglio è sbagliato, ti fermi lì e non paghi altro. Il render finale gira solo sulla versione esatta che hai approvato. Se cambi il clip, il soggetto o il riferimento, l'approvazione si azzera.
Higgsfield non ti mostra questa fase. Pensiamo che sia la più utile, perché una maschera sbagliata è il motivo principale per cui un render a pagamento torna sbagliato.
Passaggio 7: render
Il render funziona in uno di due modi:
- Via Seedance Premium. Seedance 2.5 reference-to-video crea una bozza economica dal video di controllo più le tue immagini di riferimento. Paghi il 1080p solo se la bozza ti piace, e il finale viene completato da quella stessa bozza, quindi ottieni ciò che hai approvato.
- Via Kling. Il clip originale e una o due immagini del personaggio vanno a Kling O3 video-to-video edit in un solo passaggio. Nessuna preparazione e nessuna bozza. È più veloce ed economica, ed è la nostra scelta predefinita per la maggior parte degli scambi.
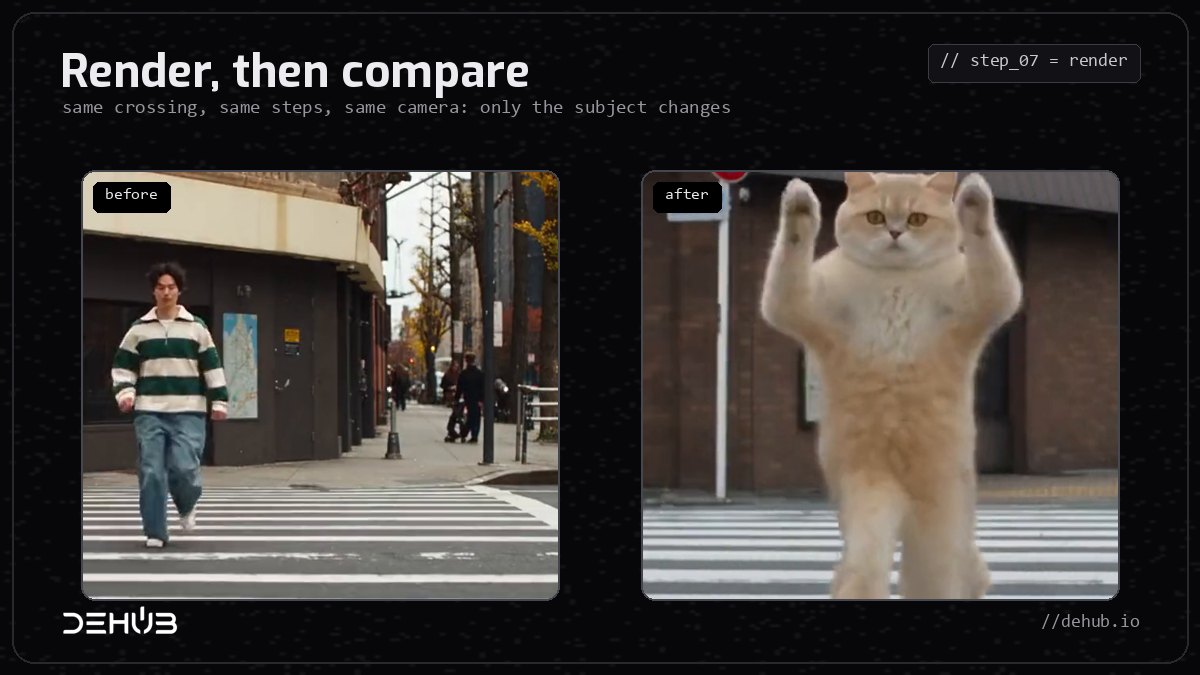
Passaggio 8: rimettere il suono originale
Entrambe le vie finiscono rimettendo la traccia audio originale completa, copiata e non ricodificata. La voce, il ritmo e i tempi sono esattamente come li hai filmati, ed è la prima cosa che si nota confrontando i risultati fianco a fianco.
Cambiare qualsiasi scena, o qualsiasi cosa al suo interno
Il 12 ottobre 2026 Higgsfield ha lanciato Katana, una skill di editing che gira dentro una chat AI. Le dai un video di riferimento, o un preset dalla sua libreria, più fino a cinque foto di persone, prodotti o abiti. Ricostruisce l'intero montaggio attorno a loro, mantenendo la struttura delle inquadrature e il ritmo del riferimento, e rifà solo le inquadrature che correggi. Richiede un piano Higgsfield attivo e consuma i crediti di quel piano.
DeHub copre lo stesso lavoro con tre strumenti, tutti con prezzo per clip:
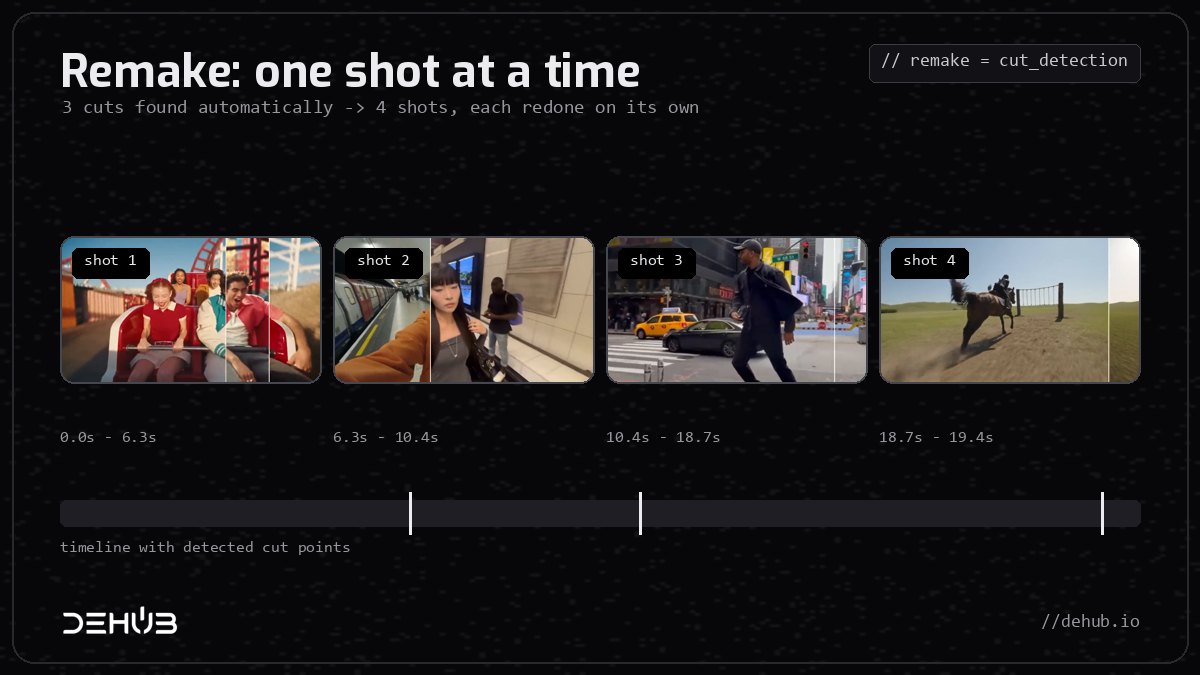
- Remake, per montaggi a più inquadrature. Carica un clip con tagli. Maboroshi trova da solo i punti di taglio, oppure li segni tu (fino a sette), e divide il clip in fino a otto inquadrature. Ogni inquadratura ha la sua regia e puoi rifare una singola inquadratura fino a cinque volte senza toccare le altre. Quando sei soddisfatto, le inquadrature vengono riunite in ordine con l'audio originale, e l'unione non costa nulla in più. Ogni inquadratura costa come un normale scambio Kling.
- Kling O3 Character Swap, per qualsiasi cosa nell'inquadratura. In DeHub Creator, questo modello inserisce personaggi, prodotti o scenari nel tuo clip partendo da fino a quattro immagini. Usalo per cambiare l'auto, la bibita in mano a qualcuno, la giacca o la strada dietro.
- Restyle Seedance 2.0, per l'intera scena. Sempre in Creator, carica un video e descrivi un nuovo look, come notte, claymation o una tempesta di neve. Il movimento resta e tutto il mondo attorno cambia.
L'immagine qui sotto mostra il rilevamento dei tagli di Remake sul nostro video promozionale. Ha trovato tre tagli automaticamente e ha diviso il clip in quattro inquadrature.
Perché possiamo farlo spendendo meno
Ogni passaggio sopra, tranne il render, costa poco da eseguire. Normalizzazione, separazione audio, profondità, maschera e mesh del volto girano sul nostro server e costano centesimi. I soldi stanno nel modello di render finale, fatturato al secondo. Quindi noi:
- Fatturiamo al secondo. Un clip da 5 secondi non costa come uno da 15.
- Saltiamo il passaggio a pagamento quando non serve. La via Kling non ha costo di preparazione né costo HD separato.
- Ti facciamo controllare prima. Approvi la maschera prima di pagare, quindi meno render a pagamento finiscono nel cestino.
- Nessun abbonamento. Paghi il clip che hai davanti, e il credito ricaricato su DeHub non scade mai.
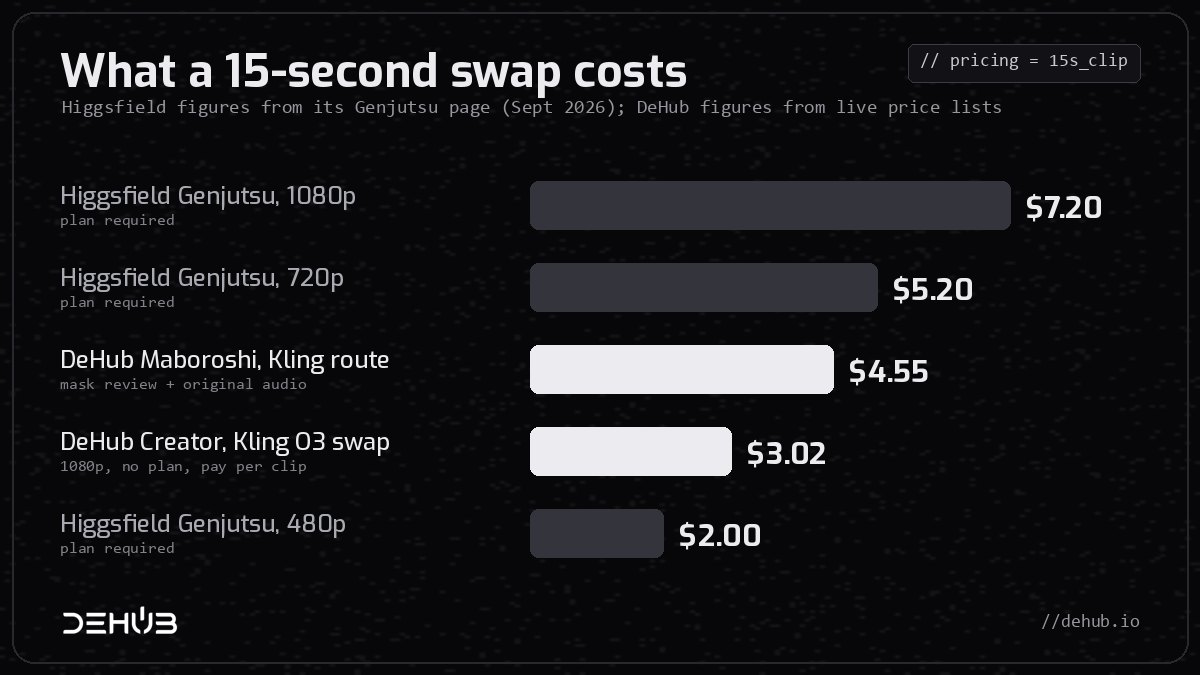
Un clip da 15 secondi, a confronto:
- Higgsfield Genjutsu, 1080p: 144 crediti, circa $7.20, piano richiesto
- Higgsfield Genjutsu, 720p: 104 crediti, circa $5.20, piano richiesto
- DeHub Maboroshi, via Kling, con revisione della maschera e audio originale: $4.55
- DeHub Creator, Kling O3 Character Swap a 1080p: $3.02
- Higgsfield Genjutsu, 480p: 40 crediti, circa $2.00, piano richiesto
Clip più corti, dove la fatturazione al secondo vince:
- 5 secondi: Maboroshi $1.75, scambio Creator $1.01
- 10 secondi: Maboroshi $3.15, scambio Creator $2.02
- 15 secondi: Maboroshi $4.55, scambio Creator $3.02
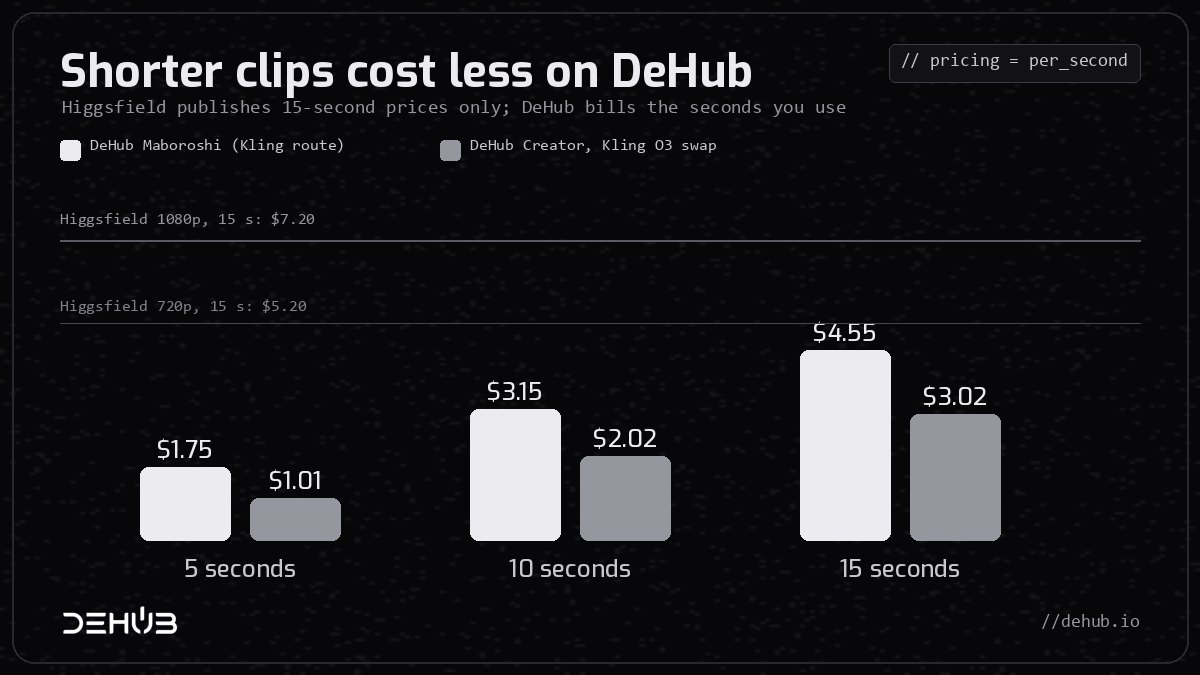
Due avvertenze oneste. Se ti serve solo un clip a 480p e paghi già un piano Higgsfield, i suoi $2.00 costano meno. E la nostra via Seedance Premium in pieno 1080p costa molto più di Higgsfield, circa $31 per 15 secondi, perché fattura ogni secondo di input e output a un prezzo vicino a quanto il modello costa a noi. Lo spieghiamo nella nostra guida all'alternativa a Higgsfield Genjutsu.
Montalo, pubblicalo, guadagnaci
Higgsfield si ferma al pulsante di download. Su DeHub il clip è un punto di partenza, non la fine del lavoro.
L'editor video integrato. L'editor video di DeHub gira nel browser e nell'app DeHub. È una vera timeline multitraccia, non un cursore per tagliare. Metti il tuo clip Maboroshi accanto agli altri filmati, poi:
- Taglia sui cambi di scena e sui battiti della musica.
- Aggiungi sottotitoli e traduci un'intera traccia di sottotitoli in un'altra lingua.
- Rimuovi gli sfondi.
- Genera una colonna sonora o effetti sonori.
- Registra lo schermo o la voce direttamente nella timeline.
I progetti si salvano nel cloud con cronologia delle versioni, e puoi condividere un montaggio per commenti di revisione con timestamp.
L'app social attorno. DeHub è un social network oltre che uno studio, quindi un montaggio finito va dritto dall'editor a un post o a uno Short. Lì gli spettatori possono darti mance e le tue visualizzazioni contano per i premi watch-to-earn. Gli spettatori di altre lingue possono attivare un doppiaggio automatico. DeHub continua ad aggiungere novità a feed, Shorts, live streaming e agenti AI che possono pubblicare secondo un programma.
Un solo account copre tutto il ciclo: fai lo scambio, montalo, pubblicalo e fatti pagare.
Provalo
- Apri dehub.io/creator/maboroshi per sostituire un soggetto, oppure scegli Kling O3 Character Swap in DeHub Creator per cambiare qualsiasi cosa nell'inquadratura.
- Carica un clip breve con audio e una o due immagini di riferimento chiare.
- Controlla la maschera, approva e avvia il render. Il prezzo è mostrato in dollari prima di pagare.
- Apri il risultato nell'editor video, completa il montaggio e pubblicalo nel tuo feed.
Domande frequenti
Come funziona Higgsfield Genjutsu?
Higgsfield non pubblica la sua pipeline. Effetti come questo si costruiscono misurando prima il clip originale: frame rate, suono, profondità, contorno del soggetto e mesh del volto. Poi un modello reference-to-video o di video edit rifà solo il soggetto, e l'audio originale viene rimesso alla fine. Maboroshi esegue esattamente questa catena, e questa guida mostra ogni passaggio.
Quali modelli usa l'editing in stile Genjutsu?
In Maboroshi: Demucs per l'audio, Video Depth Anything per la profondità, SAM 3 Video per la maschera, MediaPipe Face Landmarker per il volto e Seedance 2.5 reference-to-video o Kling O3 video-to-video edit per il render.
Maboroshi costa meno di Higgsfield Genjutsu?
A 720p e 1080p, sì. Un clip da 15 secondi costa $4.55 sulla via Kling di Maboroshi e $3.02 con il Kling O3 Character Swap di Creator, contro circa $5.20 e $7.20 su Higgsfield. Nessuna delle due opzioni DeHub richiede un abbonamento. L'opzione 480p di Higgsfield, a circa $2.00, costa meno se hai già un piano.
Cos'è Higgsfield Katana, e DeHub ha qualcosa di simile?
Katana è la skill di Higgsfield basata su chat per ricostruire un montaggio di riferimento con le tue persone, i tuoi prodotti o i tuoi abiti. Su DeHub, Remake ricostruisce clip a più inquadrature una inquadratura alla volta, Kling O3 Character Swap cambia personaggi, prodotti o scenari, e Seedance 2.0 dà un nuovo stile a un'intera scena. Tutti e tre hanno prezzo per clip.
Posso cambiare lo sfondo o gli oggetti, non solo la persona?
Sì. Usa Kling O3 Character Swap in DeHub Creator per sostituire prodotti o scenari da immagini di riferimento, oppure Seedance 2.0 per dare un nuovo stile all'intero clip con un prompt. Maboroshi invece mantiene lo sfondo esattamente come è stato girato, che è ciò che vuoi per uno scambio pulito del soggetto.
L'audio originale resta?
Sì. Su entrambe le vie di Maboroshi la traccia originale completa viene ricopiata sul clip finito, intatta.
Note legali
I dati su Genjutsu di Higgsfield provengono dalla sua pagina Genjutsu, verificata a settembre 2026. I dettagli su Katana provengono dall'articolo di Higgsfield su Katana del 12 ottobre 2026. Higgsfield prezza in crediti e cambia spesso i suoi piani, quindi controlla i prezzi aggiornati prima di confrontare. I prezzi DeHub sono tariffe al dettaglio al momento della stesura, e il prezzo mostrato prima di ogni passaggio è sempre quello che paghi. L'immagine di profondità del passaggio 3 è stata fatta con un modello a fotogramma singolo a scopo illustrativo. Maboroshi usa Video Depth Anything.