Wie funktioniert Higgsfield Genjutsu? Und wie Maboroshi denselben Job günstiger erledigt (2026)
By DeHub Team — 2026-10-24
Higgsfield Genjutsu nimmt ein echtes Video und tauscht eine Sache darin aus: eine Person, ein Haustier, ein Produkt, ein Outfit. Kamerafahrt, Timing und Hintergrund bleiben genau wie gefilmt. Higgsfield verrät nicht, wie es funktioniert, deshalb halten es die meisten für ein einziges geheimes Modell.
Ist es nicht. Nimmt man es auseinander, ist Bearbeitung im Genjutsu-Stil eine Kette aus acht Schritten, und fast jedes Glied ist ein bekanntes offenes Modell. Wir haben diese Kette als Maboroshi in DeHub Creator nachgebaut. Weil wir sie selbst betreiben, wissen wir, wohin die Kosten wirklich fließen, und genau deshalb können wir weniger verlangen.
Dieser Guide geht jeden Schritt mit einem echten Bild durch. Danach geht es darum, eine ganze Szene zu ändern, was jede Option kostet und was mit deinem Clip passiert, sobald er fertig ist.
Was Higgsfield Genjutsu macht
Laut Higgsfields eigener Genjutsu-Seite gibt es zwei Modi:
- Motion Transfer. Die Bewegung aus deinem Clip steuert eine neue Figur oder eine neu aufgebaute Szene.
- Object Swap. Ein Element, das du benennst, wird ersetzt, der Rest der Einstellung bleibt. Higgsfields Beispiele sind Produkte, Requisiten und Outfits.
Du lädst einen Clip von 4 bis 30 Sekunden hoch, fügst bis zu 30 Referenzbilder hinzu und wählst eines von über 30 Presets oder schreibst eine kurze Beschreibung. Ausgegeben wird bis 1080p. Welche Modelle darunter laufen, sagt Higgsfield nicht.
Was du sehen kannst, ist das Ergebnis. Die Kamerafahrt bleibt, das Licht passt, das neue Motiv steht hinter den richtigen Objekten, und der Mund bewegt sich im Takt der Stimme. Ein Text-zu-Video-Modell allein schafft das nicht, also muss zuerst etwas den Originalclip vermessen. Dieses Vermessen nennen viele Reverse Engineering, und es zerfällt in acht Aufgaben.
So funktioniert es, Schritt für Schritt
Unser Ausgangspunkt war der MIT-lizenzierte Genjutsu Open Source Workflow von Sirio Berati. Er hat gezeigt, dass sich der Effekt aus offenen Bausteinen nachbauen lässt. Wir haben die wichtigen Schritte behalten, die für echte Nutzer unsicheren ersetzt und Zahlungen, Freigabe und Wiederherstellung ergänzt. Jedes Bild unten entstand, indem der Schritt auf einem echten Clip ausgeführt wurde.
Schritt 1: Den Clip normalisieren
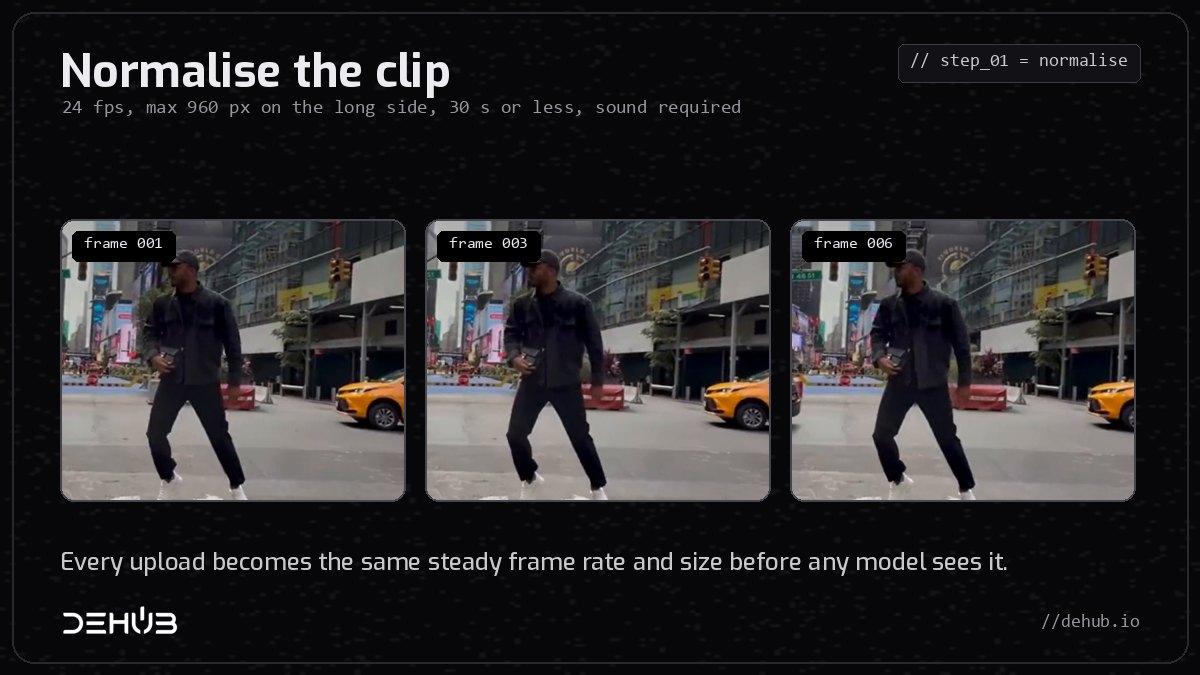
Jeder Upload wird auf konstante 24 Bilder pro Sekunde umgerechnet und auf höchstens 960 Pixel an der langen Seite skaliert. Handyvideos haben oft eine schwankende Bildrate, wodurch ein Modell aus dem Takt gerät. Feste Bildrate und feste Größe geben jedem weiteren Schritt dasselbe Raster und halten die Verarbeitung schnell und günstig.
Der Clip darf höchstens 30 Sekunden lang sein und muss eine Tonspur haben. Auf der Kling-Route von Maboroshi muss er 3 bis 15 Sekunden lang sein, mit mindestens 720 Pixeln pro Seite.
Schritt 2: Den Soundtrack abnehmen
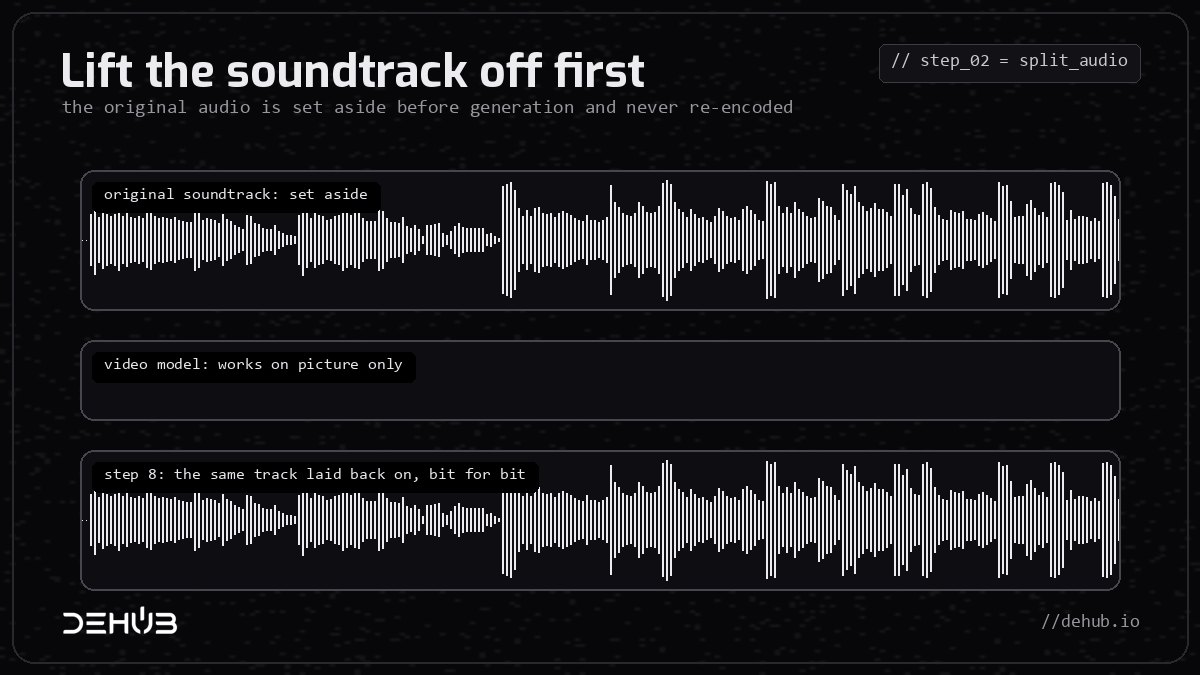
Der Ton wird abgenommen, bevor irgendetwas generiert wird. Demucs, ein offenes Modell, trennt Stimme und Musik, damit das Videomodell nur bekommt, was es braucht. Die komplette Originalspur wird unangetastet beiseitegelegt.
Deshalb klingt der fertige Clip genau wie dein Original. Videomodelle sind schlecht im Ton: Sie verschieben ihn, verschmieren ihn oder erfinden neue Geräusche. Also läuft die Originalspur gar nicht erst durch das Modell.
Schritt 3: Die Tiefe kartieren
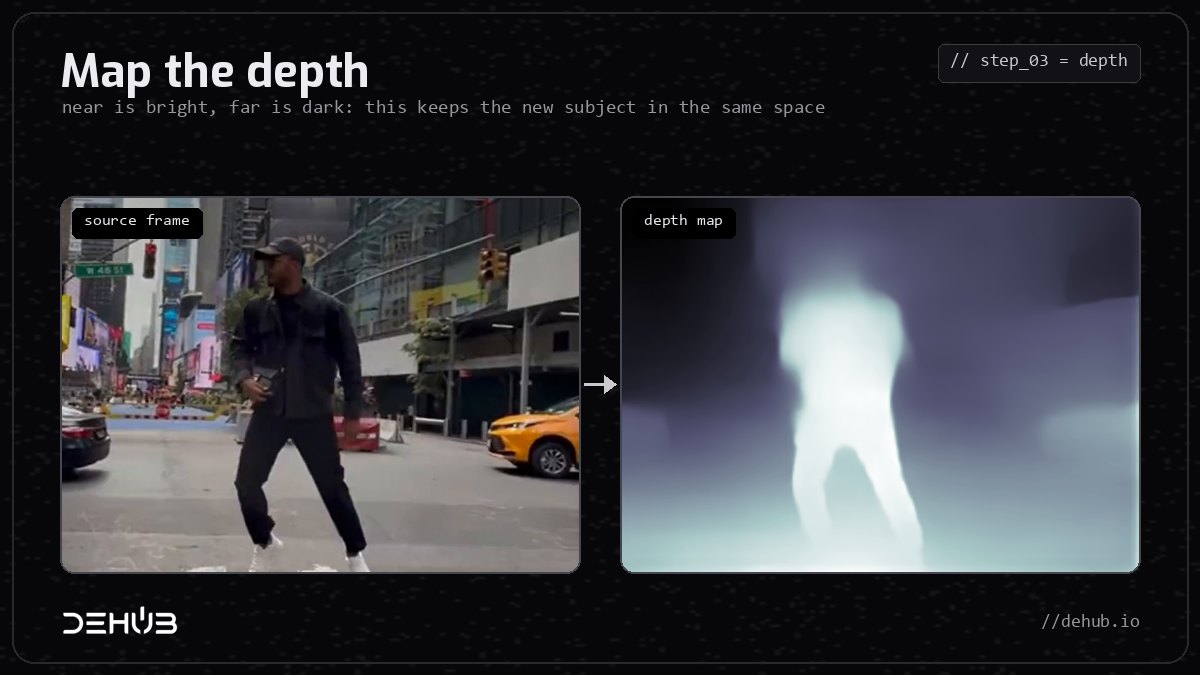
Ein Tiefenmodell schätzt Bild für Bild, wie weit jeder Pixel von der Kamera entfernt ist. Maboroshi nutzt Video Depth Anything, das für Video gebaut ist und von Bild zu Bild stabil bleibt. Das Bild unten wurde mit einem kleineren Tiefenmodell für Einzelbilder erstellt, aber das Prinzip ist dasselbe: nah ist hell, fern ist dunkel.
Die Tiefe sorgt dafür, dass das neue Motiv an derselben Stelle steht, in der richtigen Größe, vor den Taxis und hinter der Laterne. Ohne sie schweben getauschte Figuren.
Schritt 4: Das Motiv freistellen
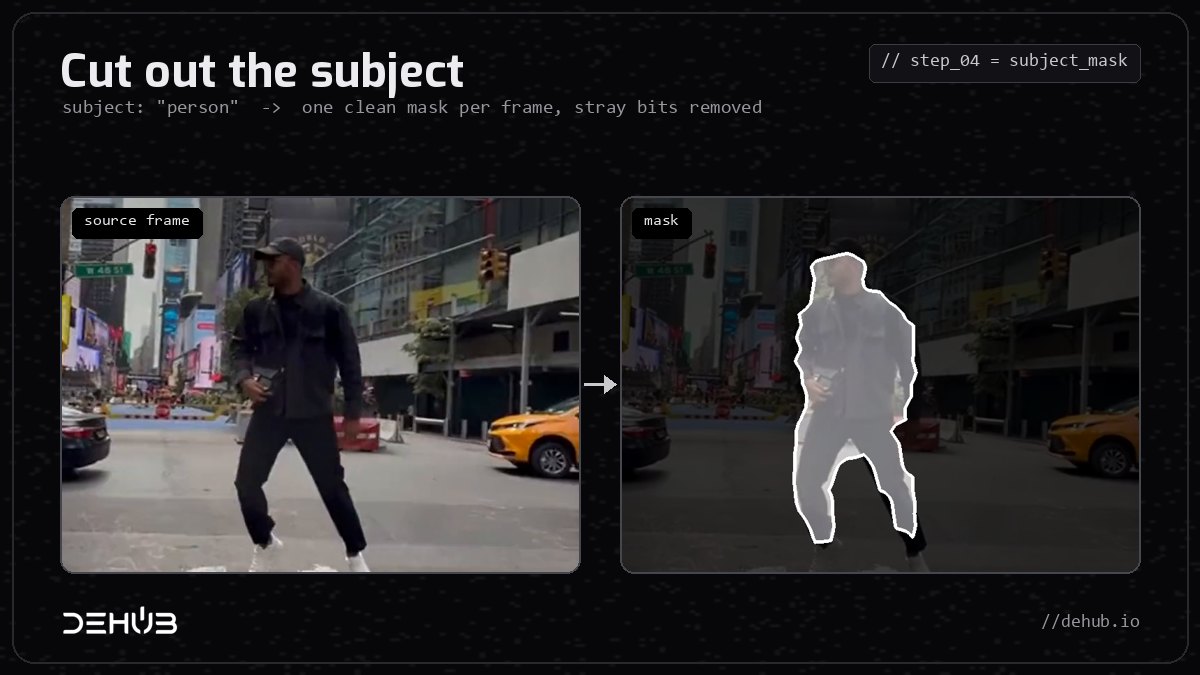
SAM 3 Video, Metas Segment Anything für Video, findet das Motiv, das du benennst (zum Beispiel "person"), und zeichnet in jedem Bild eine saubere Maske darum. Kleine Fragmente an den Rändern werden automatisch entfernt, damit verirrte Pixel das Modell nicht verwirren. Die Maske sagt dem Renderer genau, was ersetzt und was in Ruhe gelassen wird.
Schritt 5: Das Gesicht verfolgen
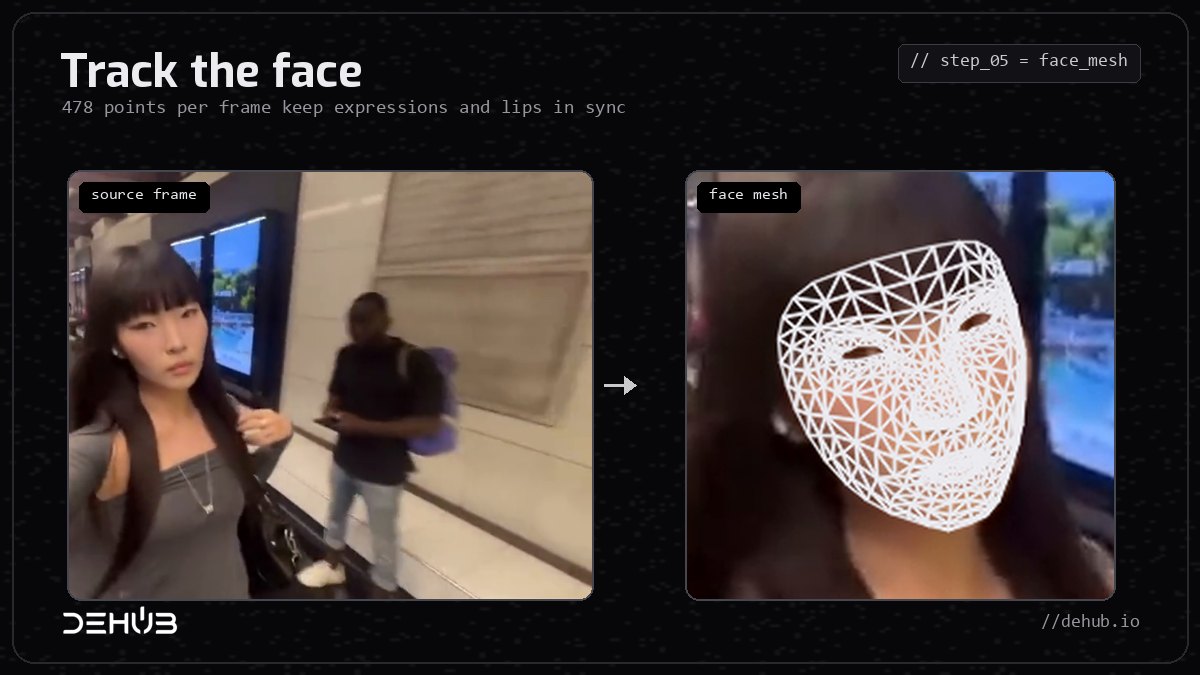
MediaPipe Face Landmarker legt in jedem Bild ein Netz aus 478 Punkten über jedes Gesicht. Dieses Netz überträgt Mimik, Kopfbewegungen und Lippenbewegungen auf die neue Figur. Deshalb kann eine getauschte Katze immer noch so aussehen, als würde sie die Zeile singen.
Schritt 6: Du prüfst das Kontrollvideo
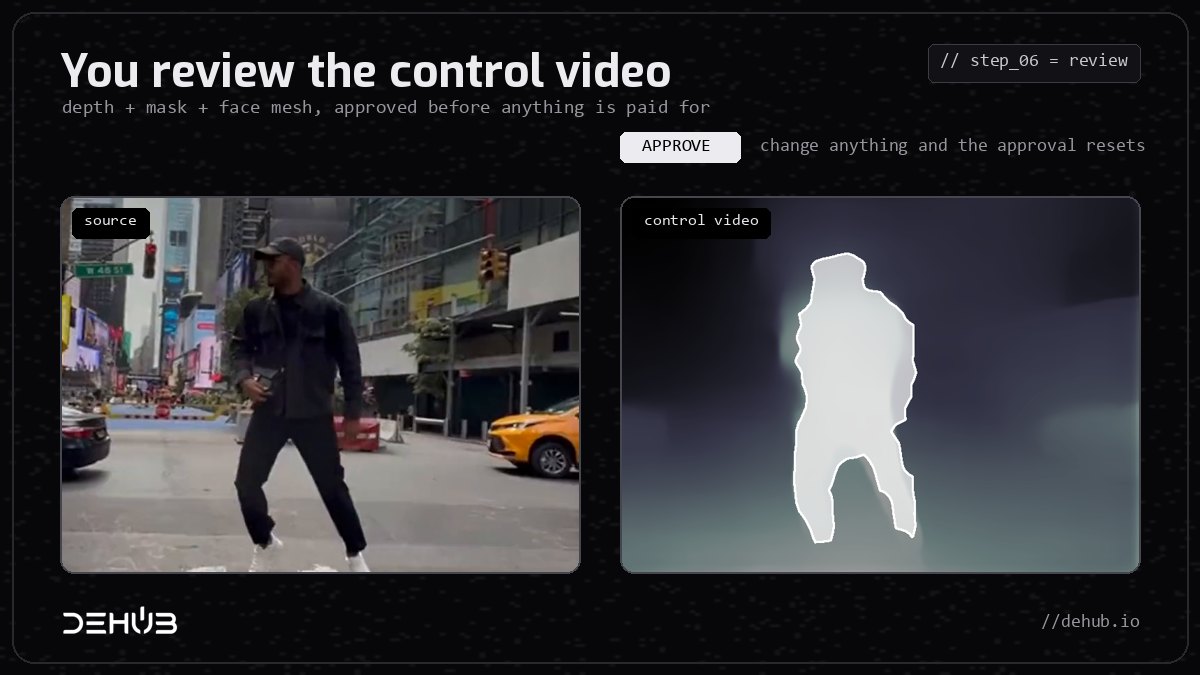
Tiefe, Maske und Gesichtsnetz werden zu einem Kontrollvideo zusammengeführt, und du siehst es, bevor etwas Teures passiert. Ist die Freistellung falsch, hörst du dort auf und zahlst nichts weiter. Das finale Rendering läuft nur auf genau der Version, die du freigegeben hast. Änderst du Clip, Motiv oder Referenz, wird die Freigabe zurückgesetzt.
Higgsfield zeigt dir diese Stufe nicht. Wir halten sie für die nützlichste, denn eine schlechte Maske ist der Hauptgrund, warum ein bezahltes Rendering falsch zurückkommt.
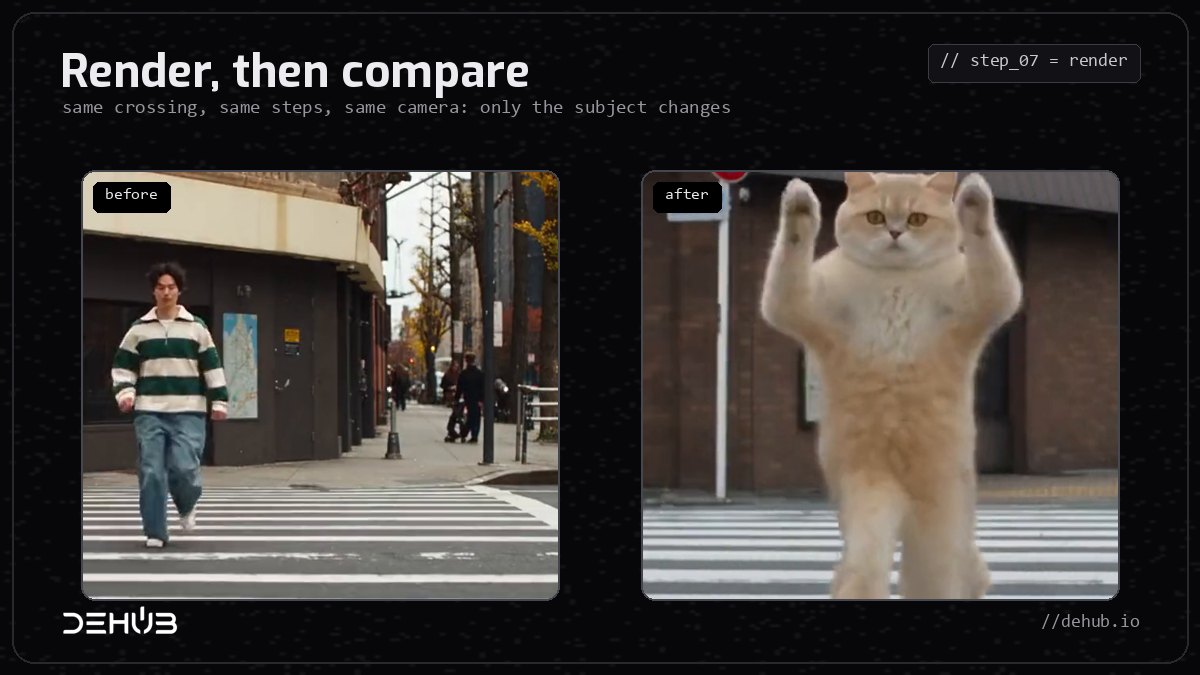
Schritt 7: Rendern
Gerendert wird auf einem von zwei Wegen:
- Seedance-Premium-Route. Seedance 2.5 reference-to-video rendert aus dem Kontrollvideo und deinen Referenzbildern einen günstigen Entwurf. Für 1080p zahlst du nur, wenn dir der Entwurf gefällt, und die finale Version wird aus genau diesem Entwurf fertiggestellt, du bekommst also, was du freigegeben hast.
- Kling-Route. Der Originalclip und ein oder zwei Figurenbilder gehen in einem Durchgang an Kling O3 video-to-video edit. Keine Vorbereitung, kein Entwurf. Das ist schneller und günstiger und unser Standard für die meisten Tausche.
Schritt 8: Den Originalton zurücklegen
Beide Routen enden damit, die komplette Original-Tonspur wieder anzulegen, kopiert statt neu kodiert. Stimme, Beat und Timing sind genau wie gefilmt, und genau das fällt Leuten als Erstes auf, wenn sie Ergebnisse nebeneinander vergleichen.
Jede Szene ändern, oder alles darin
Am 12. Oktober 2026 hat Higgsfield Katana gestartet, eine Bearbeitungsfähigkeit, die in einem KI-Chat läuft. Du gibst ihr ein Referenzvideo oder ein Preset aus ihrer Bibliothek, dazu bis zu fünf Fotos von Personen, Produkten oder Kleidung. Sie baut den ganzen Schnitt darum herum neu auf, behält Einstellungsstruktur und Tempo der Referenz bei und rendert nur die Einstellungen neu, die du korrigierst. Sie braucht ein aktives Higgsfield-Abo und verbraucht dessen Credits.
DeHub deckt denselben Job mit drei Tools ab, alle pro Clip bepreist:
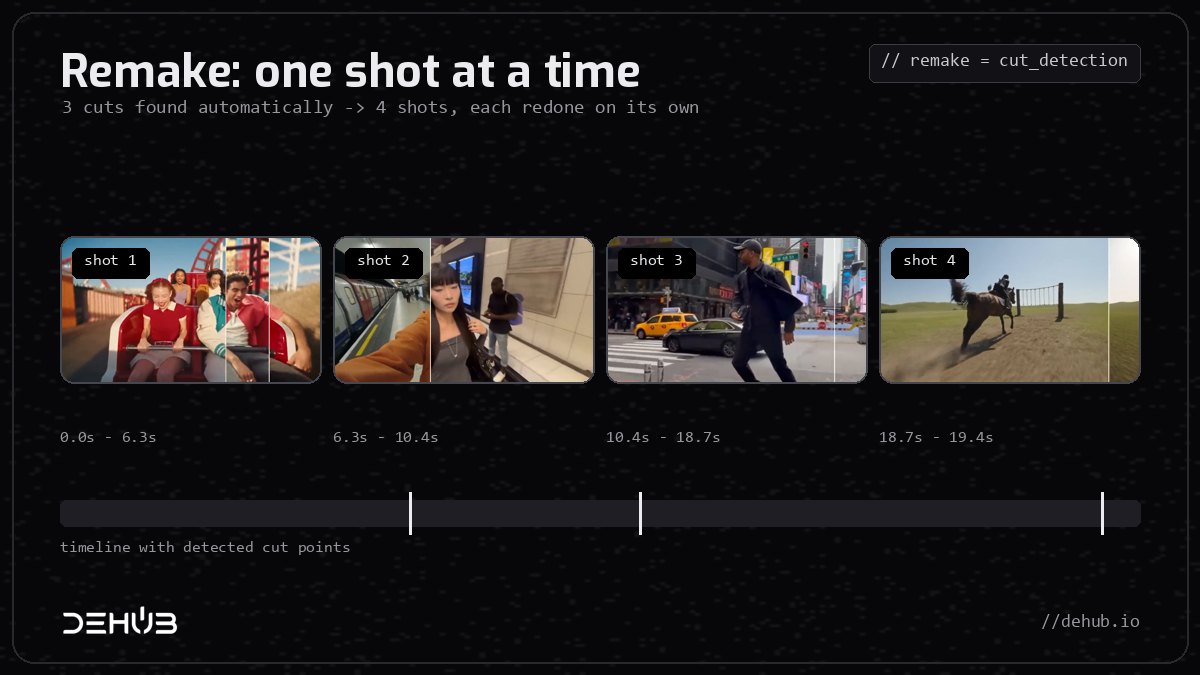
- Remake, für Schnitte mit mehreren Einstellungen. Lade einen Clip mit Schnitten hoch. Maboroshi findet die Schnittpunkte selbst, oder du markierst sie (bis zu sieben), und teilt den Clip in bis zu acht Einstellungen. Jede Einstellung bekommt ihre eigene Regie, und du kannst jede einzelne bis zu fünfmal neu machen, ohne den Rest anzufassen. Wenn du zufrieden bist, werden die Einstellungen in der richtigen Reihenfolge mit dem Originalton wieder zusammengesetzt, und das Zusammensetzen kostet nichts extra. Jede Einstellung kostet so viel wie ein normaler Kling-Tausch.
- Kling O3 Character Swap, für alles im Bild. In DeHub Creator tauscht dieses Modell Figuren, Produkte oder Kulissen in deinen Clip, auf Basis von bis zu vier Bildern. Damit änderst du das Auto, das Getränk in jemandes Hand, die Jacke oder die Straße dahinter.
- Seedance 2.0 restyle, für die ganze Szene. Ebenfalls in Creator: Lade ein Video hoch und beschreibe einen neuen Look, etwa Nacht, Knetanimation oder einen Schneesturm. Die Bewegung bleibt, und die ganze Welt drumherum verändert sich.
Das Bild unten zeigt die Schnitterkennung von Remake an unserem eigenen Promovideo. Sie hat automatisch drei Schnitte gefunden und den Clip in vier Einstellungen geteilt.
Warum wir es günstiger können
Jeder Schritt oben außer dem Rendering ist billig im Betrieb. Normalisieren, Tontrennung, Tiefe, Maske und Gesichtsnetz laufen auf unserem eigenen Server und kosten Cent-Beträge. Das Geld steckt im finalen Rendermodell, das pro Sekunde abgerechnet wird. Deshalb:
- Rechnen wir pro Sekunde ab. Ein 5-Sekunden-Clip kostet nicht so viel wie einer mit 15 Sekunden.
- Lassen wir den bezahlten Schritt weg, wenn er nicht nötig ist. Die Kling-Route hat keine Vorbereitungsgebühr und keine separate HD-Gebühr.
- Lassen wir dich zuerst prüfen. Du gibst die Maske frei, bevor du zahlst, also landen weniger bezahlte Renderings im Müll.
- Verlangen wir kein Abo. Du zahlst für den Clip vor dir, und Guthaben, das du auf DeHub auflädst, verfällt nie.
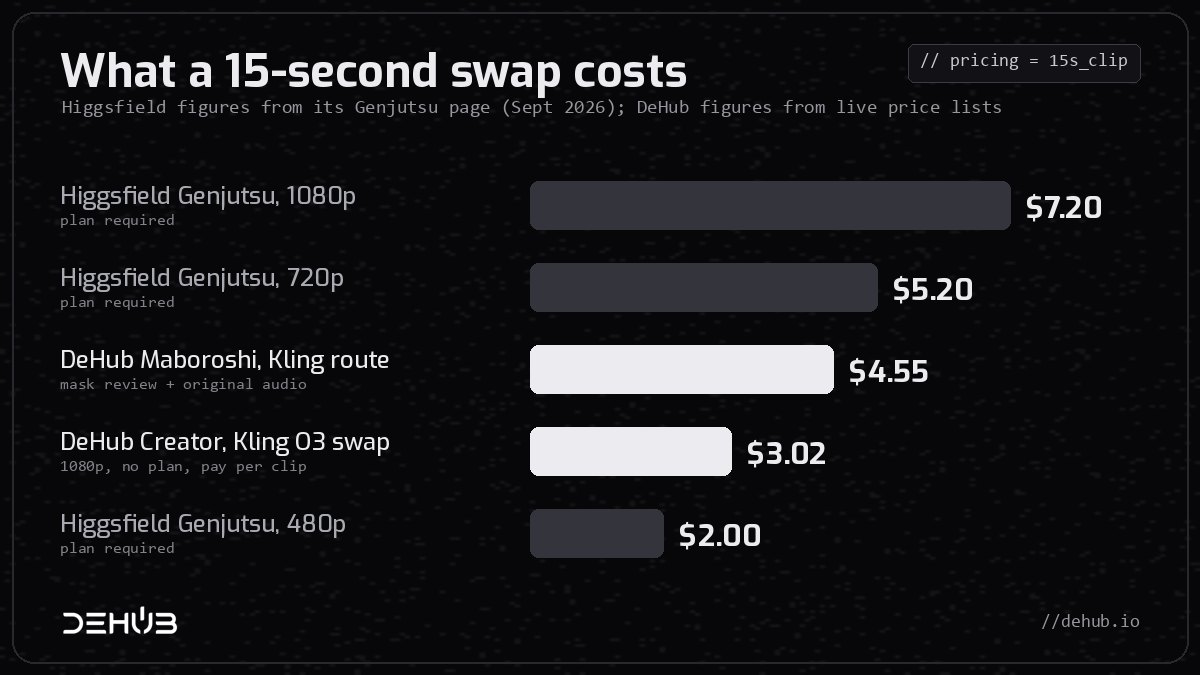
Ein 15-Sekunden-Clip im direkten Vergleich:
- Higgsfield Genjutsu, 1080p: 144 Credits, etwa $7.20, Abo nötig
- Higgsfield Genjutsu, 720p: 104 Credits, etwa $5.20, Abo nötig
- DeHub Maboroshi, Kling-Route, mit Maskenprüfung und Originalton: $4.55
- DeHub Creator, Kling O3 Character Swap in 1080p: $3.02
- Higgsfield Genjutsu, 480p: 40 Credits, etwa $2.00, Abo nötig
Kürzere Clips, bei denen die Abrechnung pro Sekunde gewinnt:
- 5 Sekunden: Maboroshi $1.75, Creator-Tausch $1.01
- 10 Sekunden: Maboroshi $3.15, Creator-Tausch $2.02
- 15 Sekunden: Maboroshi $4.55, Creator-Tausch $3.02
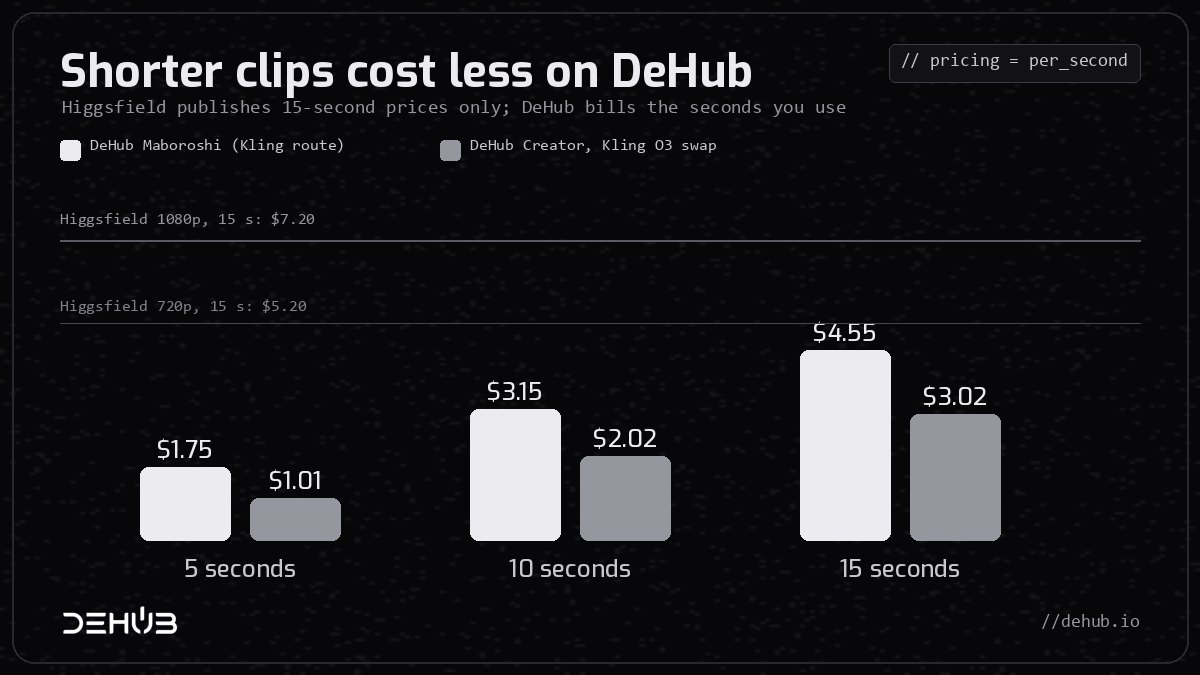
Zwei ehrliche Einschränkungen. Wenn du nur einen 480p-Clip brauchst und schon ein Higgsfield-Abo bezahlst, sind dessen $2.00 günstiger. Und unsere Seedance-Premium-Route in vollem 1080p kostet deutlich mehr als Higgsfield, etwa $31 für 15 Sekunden, weil sie jede Ein- und Ausgabesekunde nahe an dem abrechnet, was uns das Modell kostet. Das schlüsseln wir in unserem Guide zur Higgsfield-Genjutsu-Alternative auf.
Schneiden, posten, verdienen
Higgsfield hört beim Download-Button auf. Auf DeHub ist der Clip ein Startpunkt, nicht das Ende der Arbeit.
Der eingebaute Videoeditor. Der Videoeditor von DeHub läuft im Browser und in der DeHub-App. Er ist eine echte Mehrspur-Timeline, kein simpler Trim-Regler. Leg deinen Maboroshi-Clip neben dein anderes Material, und dann:
- Schneide an Szenenwechseln und Musik-Beats.
- Füge Untertitel hinzu und übersetze eine ganze Untertitelspur in eine andere Sprache.
- Entferne Hintergründe.
- Generiere einen Soundtrack oder Soundeffekte.
- Nimm deinen Bildschirm oder deine Stimme direkt in die Timeline auf.
Projekte werden mit Versionsverlauf in der Cloud gespeichert, und du kannst einen Schnitt für Kommentare mit Zeitstempel teilen.
Die Social-App drumherum. DeHub ist ein soziales Netzwerk und ein Studio zugleich, daher geht ein fertiger Schnitt direkt vom Editor in einen Post oder einen Short. Dort können dir Zuschauer Trinkgeld geben, und deine Aufrufe zählen für Watch-to-Earn-Belohnungen. Zuschauer mit anderen Sprachen können eine automatische Synchronisation einschalten. DeHub baut den Feed, Shorts, Livestreaming und KI-Agenten, die nach Zeitplan posten können, laufend aus.
Ein Konto deckt den ganzen Kreislauf ab: Tausch machen, zu einem Schnitt verarbeiten, posten und dafür bezahlt werden.
Probier es aus
- Öffne dehub.io/creator/maboroshi für einen Motivtausch, oder wähle Kling O3 Character Swap in DeHub Creator, um alles im Bild zu ändern.
- Lade einen kurzen Clip mit Ton und ein oder zwei klare Referenzbilder hoch.
- Prüfe die Maske, gib sie frei und rendere. Der Preis wird in Dollar angezeigt, bevor du zahlst.
- Öffne das Ergebnis im Videoeditor, mach deinen Schnitt fertig und poste ihn in deinem Feed.
Häufige Fragen
Wie funktioniert Higgsfield Genjutsu?
Higgsfield veröffentlicht seine Pipeline nicht. Effekte wie dieser entstehen, indem zuerst der Originalclip vermessen wird: Bildrate, Ton, Tiefe, Umriss des Motivs und Gesichtsnetz. Danach rendert ein Reference-to-Video- oder Videobearbeitungsmodell nur das Motiv neu, und am Ende kommt der Originalton wieder darauf. Maboroshi betreibt genau diese Kette, und dieser Guide zeigt jeden Schritt.
Welche Modelle nutzt Bearbeitung im Genjutsu-Stil?
In Maboroshi: Demucs für den Ton, Video Depth Anything für die Tiefe, SAM 3 Video für die Maske, MediaPipe Face Landmarker für das Gesicht und Seedance 2.5 reference-to-video oder Kling O3 video-to-video edit für das Rendering.
Ist Maboroshi günstiger als Higgsfield Genjutsu?
In 720p und 1080p ja. Ein 15-Sekunden-Clip kostet auf Maboroshis Kling-Route $4.55 und mit Kling O3 Character Swap in Creator $3.02, gegenüber etwa $5.20 und $7.20 bei Higgsfield. Keine der DeHub-Optionen braucht ein Abo. Higgsfields 480p-Option für etwa $2.00 ist günstiger, wenn du schon ein Abo hast.
Was ist Higgsfield Katana, und hat DeHub etwas Ähnliches?
Katana ist Higgsfields chatbasierte Fähigkeit, einen Referenzschnitt mit deinen eigenen Personen, Produkten oder Kleidungsstücken neu aufzubauen. Auf DeHub baut Remake Clips mit mehreren Einstellungen Einstellung für Einstellung neu auf, Kling O3 Character Swap tauscht Figuren, Produkte oder Kulissen, und Seedance 2.0 gibt einer ganzen Szene einen neuen Stil. Alle drei werden pro Clip bepreist.
Kann ich Hintergrund oder Objekte ändern, nicht nur die Person?
Ja. Nutze Kling O3 Character Swap in DeHub Creator, um Produkte oder Kulissen anhand von Referenzbildern zu tauschen, oder Seedance 2.0, um den ganzen Clip per Prompt neu zu gestalten. Maboroshi selbst lässt den Hintergrund genau wie gefilmt, und genau das willst du für einen sauberen Motivtausch.
Bleibt der Originalton erhalten?
Ja. Auf beiden Maboroshi-Routen wird die komplette Originalspur unangetastet zurück auf den fertigen Clip kopiert.
Das Kleingedruckte
Higgsfields Genjutsu-Zahlen stammen von seiner Genjutsu-Seite, Stand September 2026. Die Angaben zu Katana stammen aus Higgsfields Katana-Artikel vom 12. Oktober 2026. Higgsfield rechnet in Credits ab und ändert seine Abos häufig, prüfe also die aktuellen Preise, bevor du vergleichst. DeHub-Preise sind die Endkundenpreise zum Zeitpunkt des Schreibens, und der vor jedem Schritt angezeigte Preis ist immer der Preis, den du zahlst. Das Tiefenbild in Schritt 3 wurde zur Veranschaulichung mit einem Tiefenmodell für Einzelbilder erstellt. Maboroshi selbst nutzt Video Depth Anything.