Hoe werkt Higgsfield Genjutsu? En hoe Maboroshi hetzelfde werk goedkoper doet (2026)
Door DeHub Team — 2026-10-24
Higgsfield Genjutsu neemt een echte video en wisselt er één ding in: een persoon, een huisdier, een product, een outfit. De camerabeweging, de timing en de achtergrond blijven precies zoals gefilmd. Higgsfield zegt niet hoe het werkt, dus de meeste mensen denken dat het één geheim model is.
Dat is het niet. Haal je het uit elkaar, dan is bewerken in Genjutsu-stijl een keten van acht stappen, en bijna elke schakel is een bekend open model. Wij hebben die keten nagebouwd als Maboroshi, in DeHub Creator. Door hem zelf te draaien zagen we waar de kosten echt zitten, en daarom kunnen we minder vragen.
Deze gids loopt elke stap door met een echt beeld van elke stap. Daarna gaat het over een hele scène veranderen, wat elke optie kost en wat er met je clip gebeurt als hij klaar is.
Wat Higgsfield Genjutsu doet
Volgens de eigen Genjutsu-pagina van Higgsfield krijg je twee modi:
- Motion Transfer. De beweging uit je clip stuurt een nieuw personage of een nagebouwde scène aan.
- Object Swap. Eén element dat je noemt wordt vervangen, de rest van het shot blijft staan. De voorbeelden van Higgsfield zijn producten, rekwisieten en outfits.
Je uploadt één clip van 4 tot 30 seconden, voegt tot 30 referentiebeelden toe en kiest een van de 30+ presets of schrijft een korte omschrijving. De uitvoer gaat tot 1080p. Higgsfield zegt niet welke modellen eronder draaien.
Wat je wel ziet, is het resultaat. De camerabeweging blijft, het licht klopt, het nieuwe onderwerp staat achter de juiste objecten en de mond beweegt in de maat van de stem. Een tekst-naar-video-model kan dat in zijn eentje niet, dus iets moet eerst de originele clip opmeten. Dat opmeten noemen mensen reverse engineering, en het valt uiteen in acht taken.
Hoe het werkt, stap voor stap
Ons startpunt was de Genjutsu Open Source Workflow van Sirio Berati, met een MIT-licentie. Die liet zien dat het effect met open onderdelen na te bouwen was. We hielden de stappen die ertoe doen, vervingen de stappen die niet veilig waren voor echte gebruikers, en voegden betalingen, controle en herstel toe. Elk beeld hieronder is gemaakt door de stap op een echte clip uit te voeren.
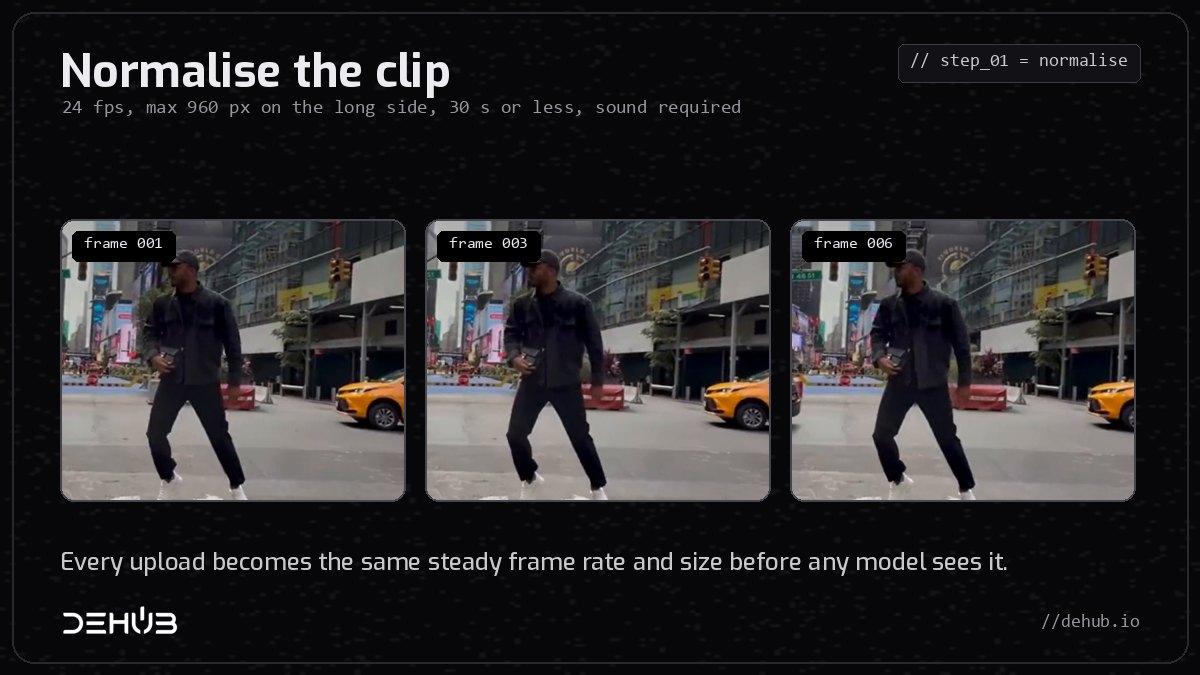
Stap 1: de clip normaliseren
Elke upload wordt omgezet naar een vaste 24 beelden per seconde en geschaald naar maximaal 960 pixels aan de lange zijde. Telefoonbeelden hebben vaak een wisselende framerate, waardoor een model uit de maat raakt. Een vaste framerate en een vaste grootte geven elke volgende stap hetzelfde raster om op te werken, en houden de verwerking snel en goedkoop.
De clip moet 30 seconden of korter zijn en een geluidsspoor hebben. Op de Kling-route van Maboroshi moet hij 3 tot 15 seconden duren, met minstens 720 pixels aan elke zijde.
Stap 2: de soundtrack eraf halen
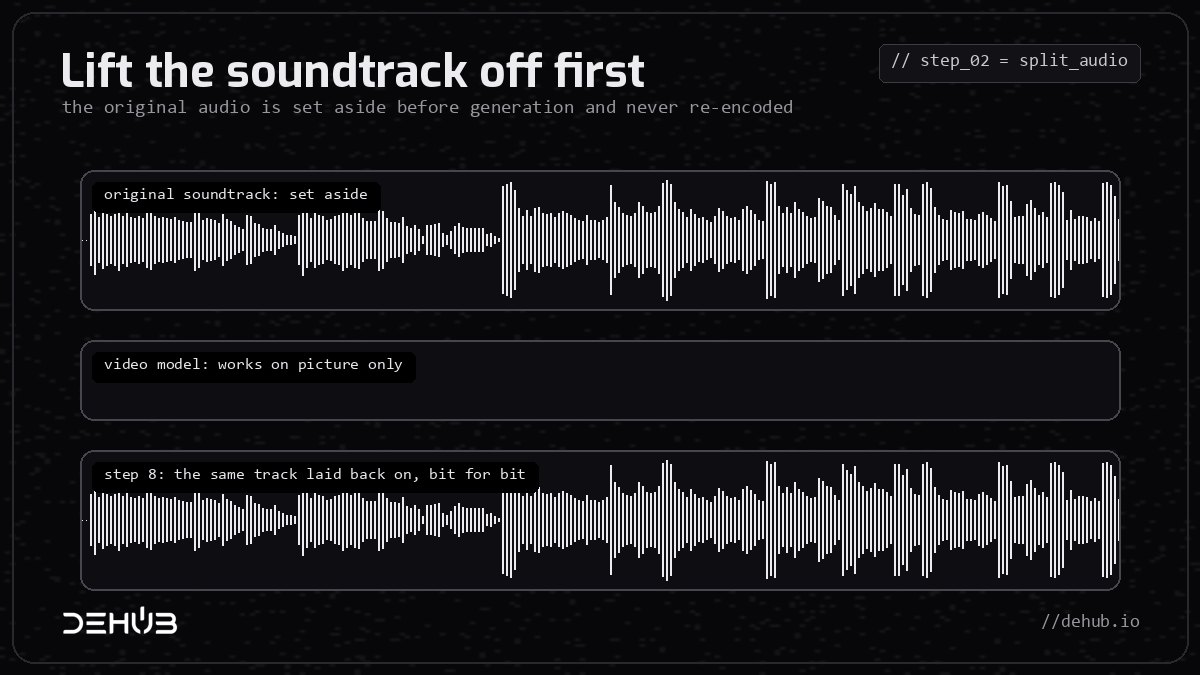
Het geluid gaat eraf voordat er iets gegenereerd wordt. Demucs, een open model, scheidt stem van muziek, zodat het videomodel alleen krijgt wat het nodig heeft. Het volledige originele spoor wordt apart gezet, onaangeroerd.
Daarom klinkt de afgewerkte clip precies als je origineel. Videomodellen zijn slecht in geluid: ze verschuiven het, smeren het uit of verzinnen nieuwe geluiden. Dus het originele spoor gaat nooit door het model.
Stap 3: de diepte in kaart brengen
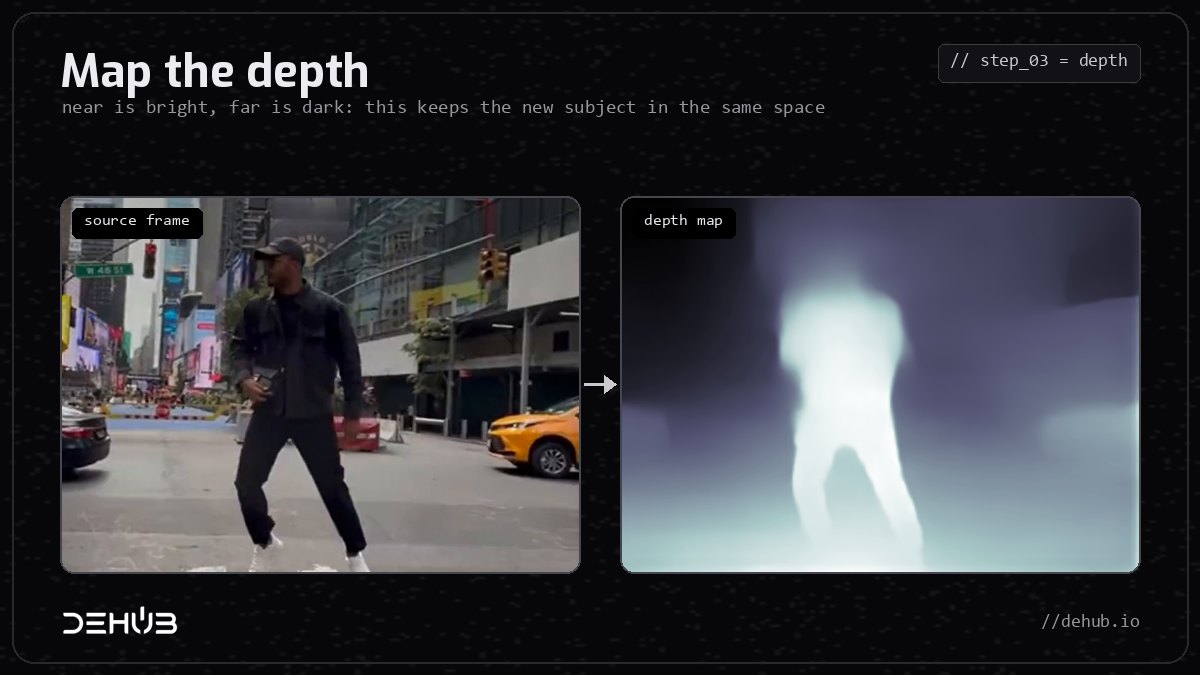
Een dieptemodel schat per beeld hoe ver elke pixel van de camera af is. Maboroshi gebruikt Video Depth Anything, dat voor video gemaakt is en stabiel blijft van het ene beeld naar het volgende. Het beeld hieronder is gemaakt met een kleiner dieptemodel voor losse beelden, maar het idee is hetzelfde: dichtbij is licht, ver weg is donker.
Diepte zorgt ervoor dat het nieuwe onderwerp op dezelfde plek staat, op het juiste formaat, voor de taxi's en achter de lantaarnpaal. Zonder diepte zweven gewisselde personages.
Stap 4: het onderwerp uitknippen
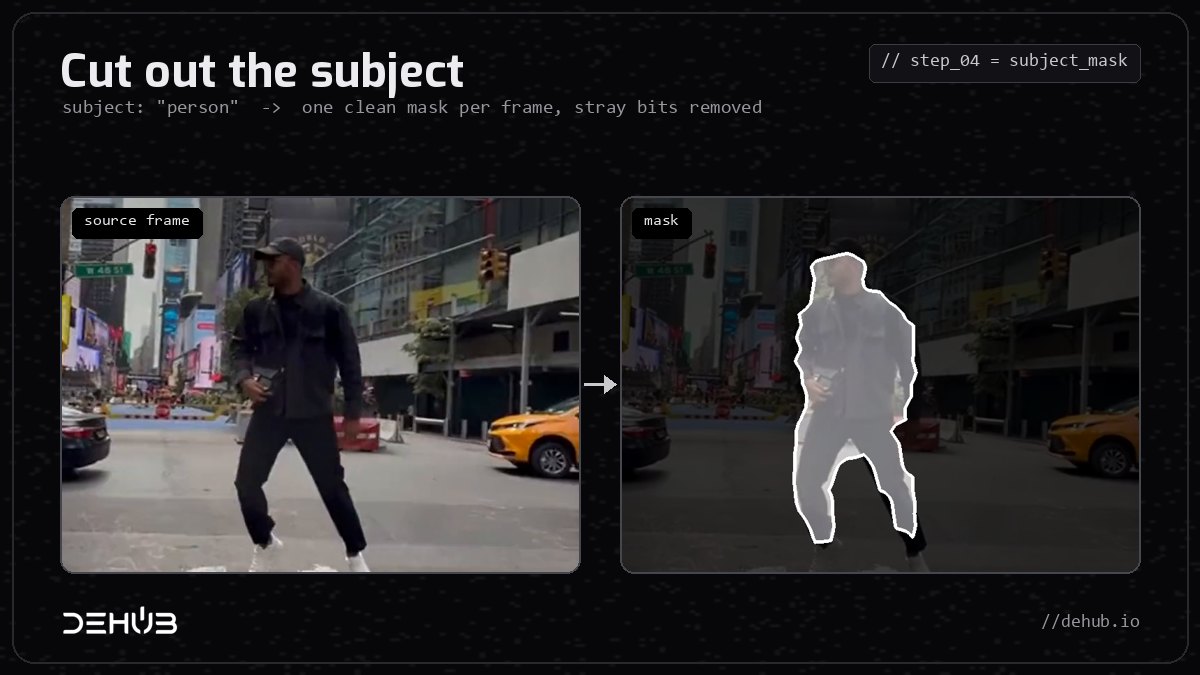
SAM 3 Video, Segment Anything van Meta voor video, vindt het onderwerp dat je noemt (bijvoorbeeld "person") en tekent er in elk beeld een strak masker omheen. Kleine stukjes aan de randen worden automatisch opgeruimd, zodat losse pixels het model niet in de war brengen. Het masker vertelt de renderer precies wat vervangen moet worden en wat met rust gelaten moet worden.
Stap 5: het gezicht volgen
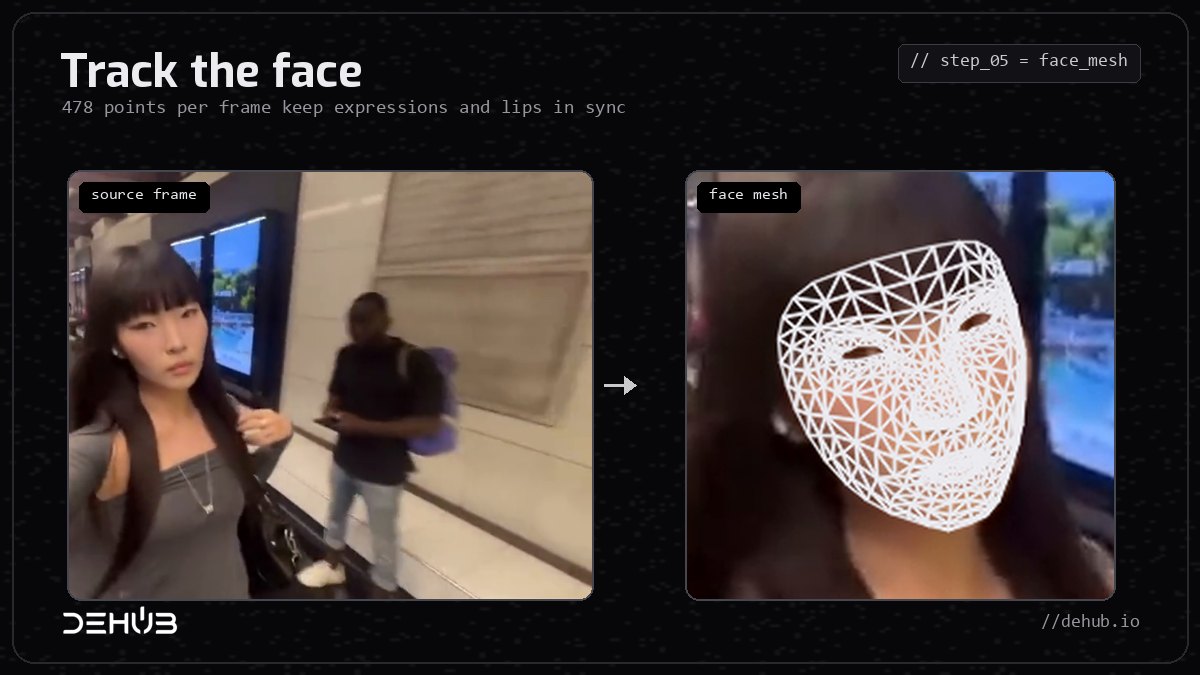
MediaPipe Face Landmarker legt in elk beeld een net van 478 punten over elk gezicht. Dat net draagt uitdrukkingen, hoofdbewegingen en lipbewegingen over naar het nieuwe personage. Daarom kan een gewisselde kat er nog steeds uitzien alsof hij de tekst zingt.
Stap 6: jij controleert de controlevideo
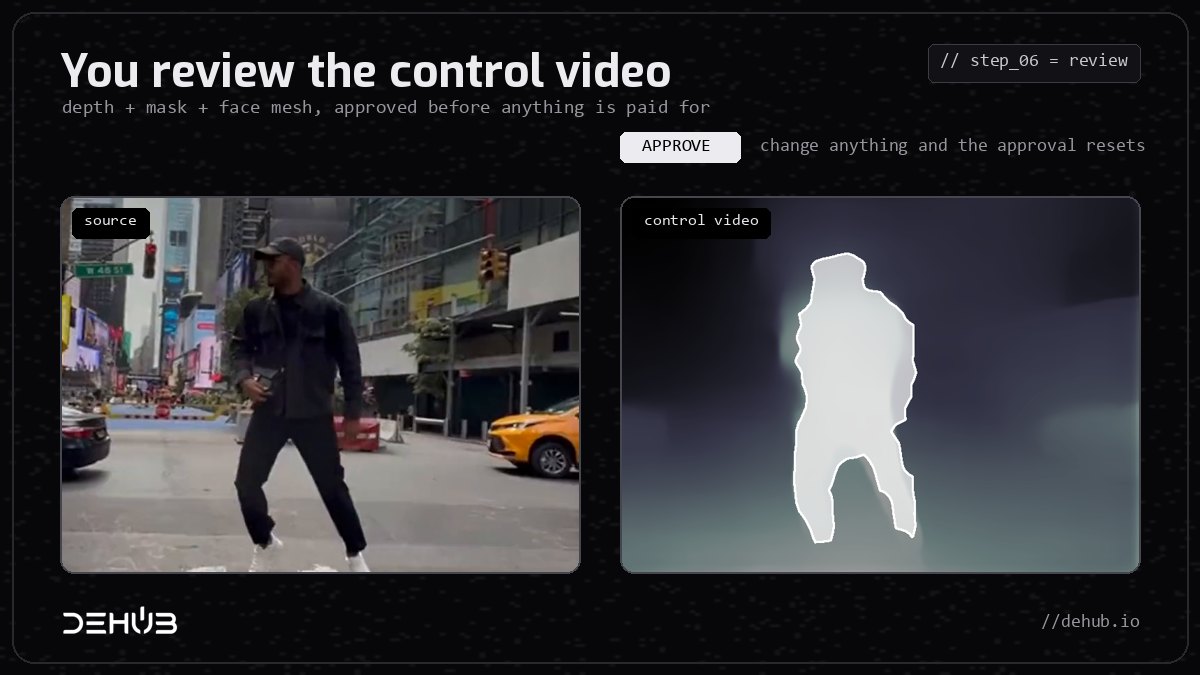
Diepte, masker en gezichtsnet worden samengevoegd tot één controlevideo, en die zie je voordat er iets duurs gebeurt. Klopt het uitknippen niet, dan stop je daar en betaal je niets meer. De uiteindelijke render draait alleen op de exacte versie die jij hebt goedgekeurd. Verander de clip, het onderwerp of de referentie en de goedkeuring vervalt.
Higgsfield laat je deze fase niet zien. Wij vinden het de nuttigste, want een slecht masker is de belangrijkste reden dat een betaalde render mislukt terugkomt.
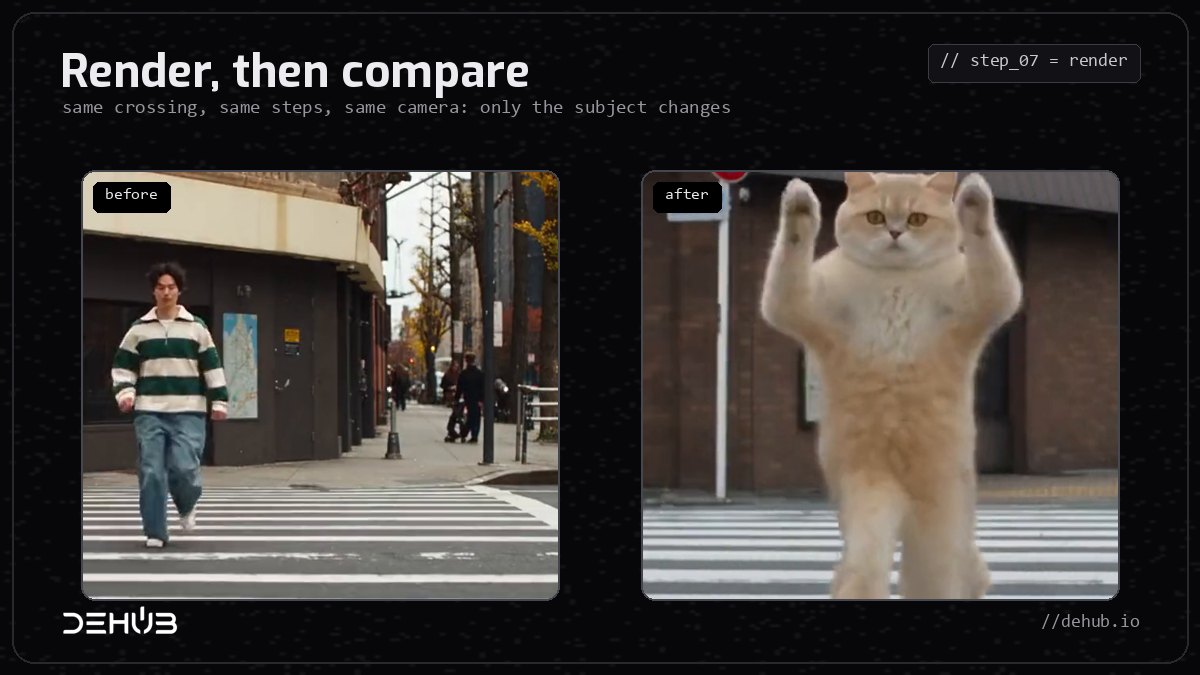
Stap 7: renderen
De render gebeurt op een van twee manieren:
- Seedance Premium-route. Seedance 2.5 reference-to-video rendert een goedkoop concept van de controlevideo plus je referentiebeelden. Je betaalt pas voor 1080p als het concept je bevalt, en de eindversie wordt van datzelfde concept afgemaakt, dus je krijgt wat je hebt goedgekeurd.
- Kling-route. De originele clip en één of twee personagebeelden gaan in één keer naar Kling O3 video-to-video edit. Geen voorbereiding en geen concept. Het is sneller en goedkoper, en onze standaard voor de meeste wissels.
Stap 8: het originele geluid terugzetten
Beide routes eindigen met het terugzetten van het volledige originele audiospoor, gekopieerd in plaats van opnieuw gecodeerd. De stem, de beat en de timing zijn precies zoals je ze filmde, en dat is het eerste wat mensen opvalt als ze resultaten naast elkaar vergelijken.
Elke scène veranderen, of alles erin
Op 12 oktober 2026 lanceerde Higgsfield Katana, een bewerkingsvaardigheid die in een AI-chat draait. Je geeft het een referentievideo, of een preset uit de bibliotheek, plus tot vijf foto's van mensen, producten of kleding. Het bouwt de hele edit om die foto's heen opnieuw op, met de shotstructuur en het tempo van de referentie, en rendert alleen de shots die je corrigeert opnieuw. Je hebt een actief Higgsfield-abonnement nodig en het verbruikt de credits van dat abonnement.
DeHub doet hetzelfde werk met drie tools, allemaal geprijsd per clip:
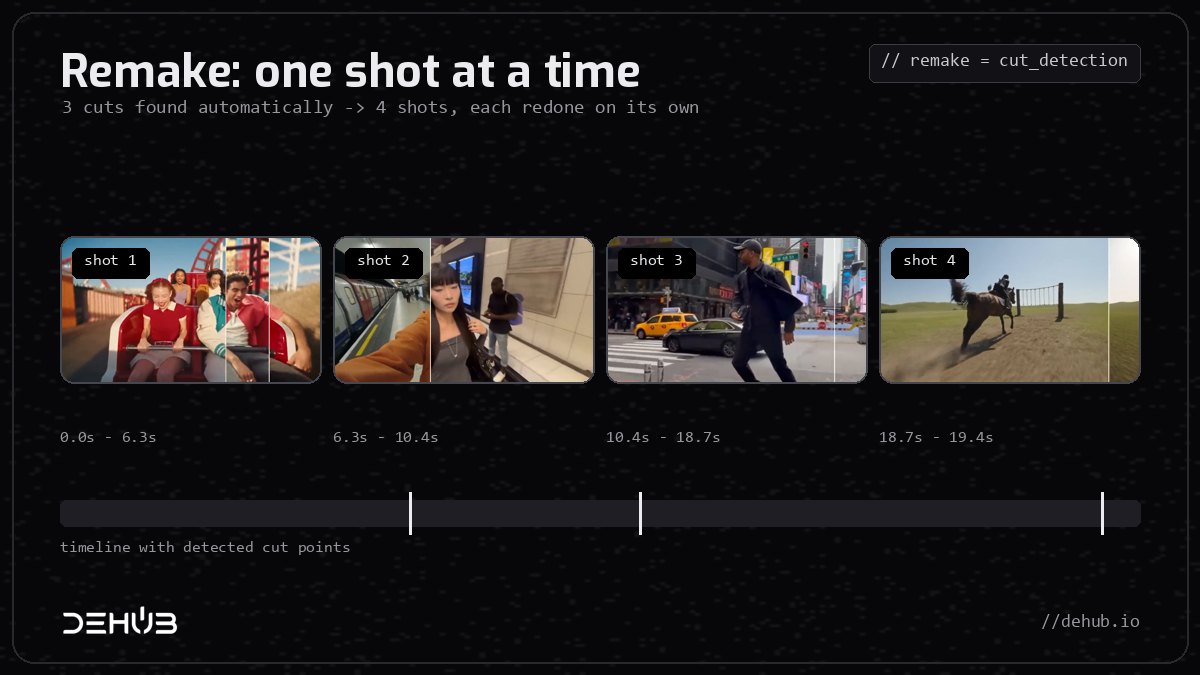
- Remake, voor edits met meerdere shots. Upload een clip met knippen. Maboroshi vindt de knippunten zelf, of je markeert ze (tot zeven), en splitst de clip in maximaal acht shots. Elk shot krijgt zijn eigen regie, en je kunt elk afzonderlijk shot tot vijf keer overdoen zonder de rest aan te raken. Ben je tevreden, dan worden de shots op volgorde weer aan elkaar gezet met het originele geluid, en dat aan elkaar zetten kost niets extra. Elk shot kost hetzelfde als een normale Kling-wissel.
- Kling O3 Character Swap, voor alles in beeld. In DeHub Creator wisselt dit model personages, producten of decors in je clip op basis van tot vier beelden. Gebruik het om de auto, het drankje in iemands hand, de jas of de straat erachter te veranderen.
- Seedance 2.0 restyle, voor de hele scène. Ook in Creator: upload een video en beschrijf een nieuwe look, zoals nacht, klei-animatie of een sneeuwstorm. De beweging blijft en de hele wereld eromheen verandert.
Het beeld hieronder toont de knipdetectie van Remake op onze eigen promovideo. Die vond automatisch drie knippen en splitste de clip in vier shots.
Waarom wij het goedkoper kunnen
Elke stap hierboven behalve de render is goedkoop om uit te voeren. Normaliseren, het geluid scheiden, diepte, maskeren en het gezichtsnet draaien op onze eigen server en kosten centen. Het geld zit in het uiteindelijke rendermodel, dat per seconde wordt afgerekend. Dus wij:
- Rekenen per seconde af. Een clip van 5 seconden wordt niet afgerekend als een van 15.
- Slaan de betaalde stap over als die niet nodig is. De Kling-route heeft geen voorbereidingskosten en geen aparte HD-kosten.
- Laten je eerst controleren. Je keurt het masker goed voordat je betaalt, dus er gaan minder betaalde renders de prullenbak in.
- Vragen geen abonnement. Je betaalt voor de clip die voor je ligt, en tegoed dat je op DeHub oplaadt verloopt nooit.
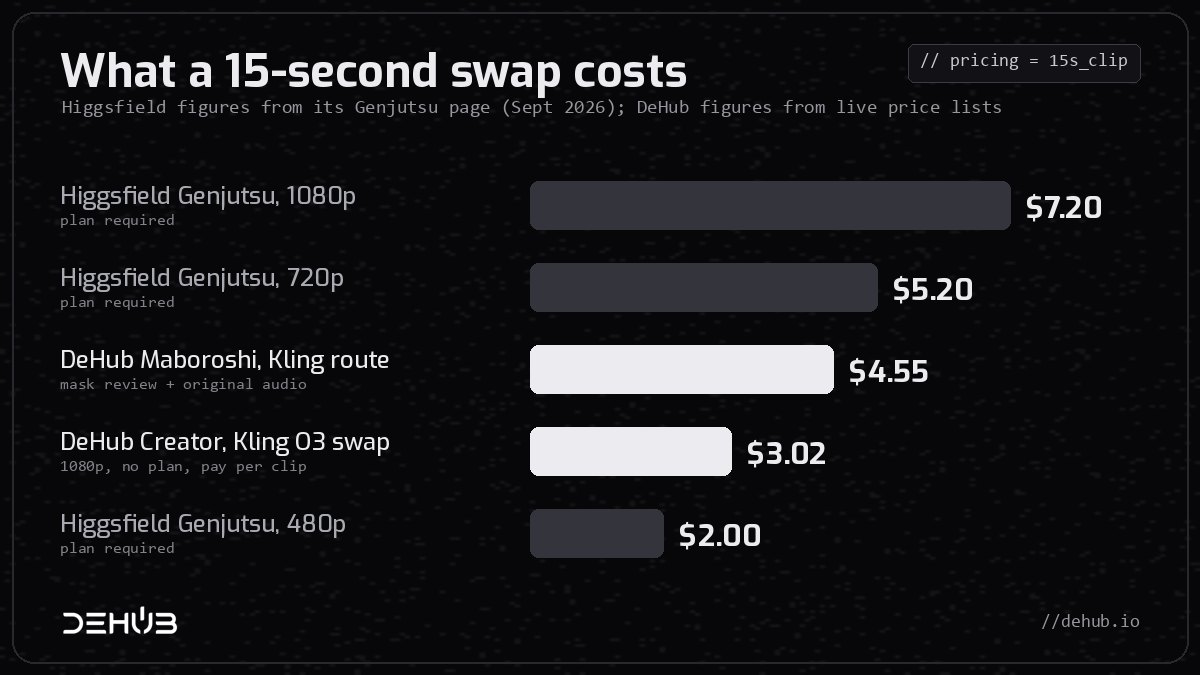
Een clip van 15 seconden, naast elkaar:
- Higgsfield Genjutsu, 1080p: 144 credits, ongeveer $7.20, abonnement vereist
- Higgsfield Genjutsu, 720p: 104 credits, ongeveer $5.20, abonnement vereist
- DeHub Maboroshi, Kling-route, met maskercontrole en origineel geluid: $4.55
- DeHub Creator, Kling O3 Character Swap op 1080p: $3.02
- Higgsfield Genjutsu, 480p: 40 credits, ongeveer $2.00, abonnement vereist
Kortere clips, waar afrekenen per seconde wint:
- 5 seconden: Maboroshi $1.75, Creator-wissel $1.01
- 10 seconden: Maboroshi $3.15, Creator-wissel $2.02
- 15 seconden: Maboroshi $4.55, Creator-wissel $3.02
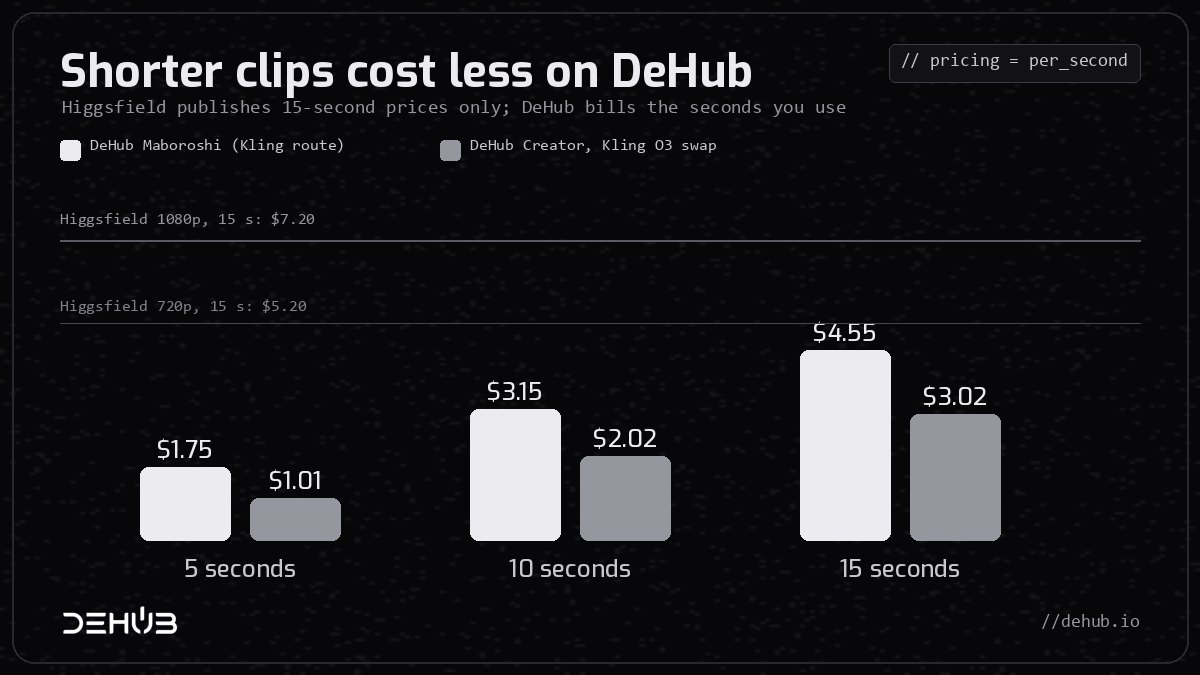
Twee eerlijke kanttekeningen. Als je alleen een 480p-clip nodig hebt en al een Higgsfield-abonnement betaalt, is hun $2.00 goedkoper. En onze Seedance Premium-route in volledige 1080p kost veel meer dan Higgsfield, ongeveer $31 voor 15 seconden, omdat die elke seconde in- en uitvoer afrekent tegen bijna wat het model ons kost. We leggen dat uit in onze gids over een alternatief voor Higgsfield Genjutsu.
Bewerk het, post het, verdien eraan
Higgsfield stopt bij de downloadknop. Op DeHub is de clip een beginpunt, niet het einde van het werk.
De ingebouwde video-editor. De video-editor van DeHub draait in je browser en in de DeHub-app. Het is een echte tijdlijn met meerdere sporen, geen simpele trimschuif. Zet je Maboroshi-clip naast je andere beelden en daarna:
- Knip op scènewisselingen en muziekbeats.
- Voeg ondertitels toe en vertaal een heel ondertitelspoor naar een andere taal.
- Verwijder achtergronden.
- Genereer een soundtrack of geluidseffecten.
- Neem je scherm of stem direct op in de tijdlijn.
Projecten worden in de cloud opgeslagen met versiegeschiedenis, en je kunt een montage delen voor opmerkingen met tijdcodes.
De sociale app eromheen. DeHub is een sociaal netwerk en ook een studio, dus een afgewerkte edit gaat rechtstreeks van de editor naar een post of een Short. Daar kunnen kijkers je fooien geven, en je weergaven tellen mee voor watch-to-earn-beloningen. Kijkers in andere talen kunnen een automatische nasynchronisatie aanzetten. DeHub breidt de feed, Shorts, livestreaming en AI-agents die volgens een schema kunnen posten steeds verder uit.
Eén account dekt de hele kringloop: maak de wissel, monteer hem tot een edit, post hem en word ervoor betaald.
Probeer het
- Open dehub.io/creator/maboroshi voor een onderwerpwissel, of kies Kling O3 Character Swap in DeHub Creator om alles in beeld te veranderen.
- Upload een korte clip met geluid en één of twee duidelijke referentiebeelden.
- Controleer het masker, keur goed en render. De prijs zie je in dollars voordat je betaalt.
- Open het resultaat in de video-editor, maak je montage af en post hem op je feed.
Veelgestelde vragen
Hoe werkt Higgsfield Genjutsu?
Higgsfield publiceert zijn pipeline niet. Effecten zoals dit worden gemaakt door eerst de originele clip op te meten: de framerate, het geluid, de diepte, de omtrek van het onderwerp en het gezichtsnet. Daarna rendert een reference-to-video- of videobewerkingsmodel alleen het onderwerp opnieuw, en aan het eind gaat het originele geluid er weer op. Maboroshi draait precies die keten, en deze gids laat elke stap zien.
Welke modellen gebruikt bewerken in Genjutsu-stijl?
In Maboroshi: Demucs voor het geluid, Video Depth Anything voor diepte, SAM 3 Video voor het masker, MediaPipe Face Landmarker voor het gezicht, en Seedance 2.5 reference-to-video of Kling O3 video-to-video edit voor de render.
Is Maboroshi goedkoper dan Higgsfield Genjutsu?
Op 720p en 1080p wel. Een clip van 15 seconden kost $4.55 op de Kling-route van Maboroshi en $3.02 met Kling O3 Character Swap in Creator, tegenover ongeveer $5.20 en $7.20 bij Higgsfield. Geen van de DeHub-opties heeft een abonnement nodig. De 480p-optie van Higgsfield, voor ongeveer $2.00, is goedkoper als je al een abonnement hebt.
Wat is Higgsfield Katana, en heeft DeHub iets vergelijkbaars?
Katana is de chatgebaseerde vaardigheid van Higgsfield om een referentie-edit opnieuw op te bouwen met je eigen mensen, producten of kleding. Op DeHub bouwt Remake clips met meerdere shots shot voor shot opnieuw op, verandert Kling O3 Character Swap personages, producten of decors, en geeft Seedance 2.0 een hele scène een nieuwe stijl. Alle drie zijn geprijsd per clip.
Kan ik de achtergrond of objecten veranderen, niet alleen de persoon?
Ja. Gebruik Kling O3 Character Swap in DeHub Creator om producten of decors te wisselen op basis van referentiebeelden, of Seedance 2.0 om de hele clip met een prompt een nieuwe stijl te geven. Maboroshi zelf houdt de achtergrond precies zoals gefilmd, en dat wil je voor een schone onderwerpwissel.
Blijft het originele geluid behouden?
Ja. Op beide Maboroshi-routes wordt het volledige originele spoor weer op de afgewerkte clip gekopieerd, onaangeroerd.
De kleine lettertjes
De Genjutsu-cijfers van Higgsfield komen van de Genjutsu-pagina zoals bekeken in september 2026. De details over Katana komen uit het Katana-artikel van Higgsfield van 12 oktober 2026. Higgsfield rekent in credits en verandert zijn abonnementen vaak, dus check de actuele prijzen voordat je vergelijkt. De prijzen van DeHub zijn de consumentenprijzen op het moment van schrijven, en de prijs die je vóór elke stap ziet, is altijd de prijs die je betaalt. Het dieptebeeld in stap 3 is ter illustratie gemaakt met een dieptemodel voor losse beelden. Maboroshi zelf gebruikt Video Depth Anything.